Visibilidad en búsquedas con IA
Cómo convertir tus datos de visibilidad en IA en una hoja de ruta de GEO en 2026

 JoseGrowthenOmniaJoseGrowthenOmnia
En resumen
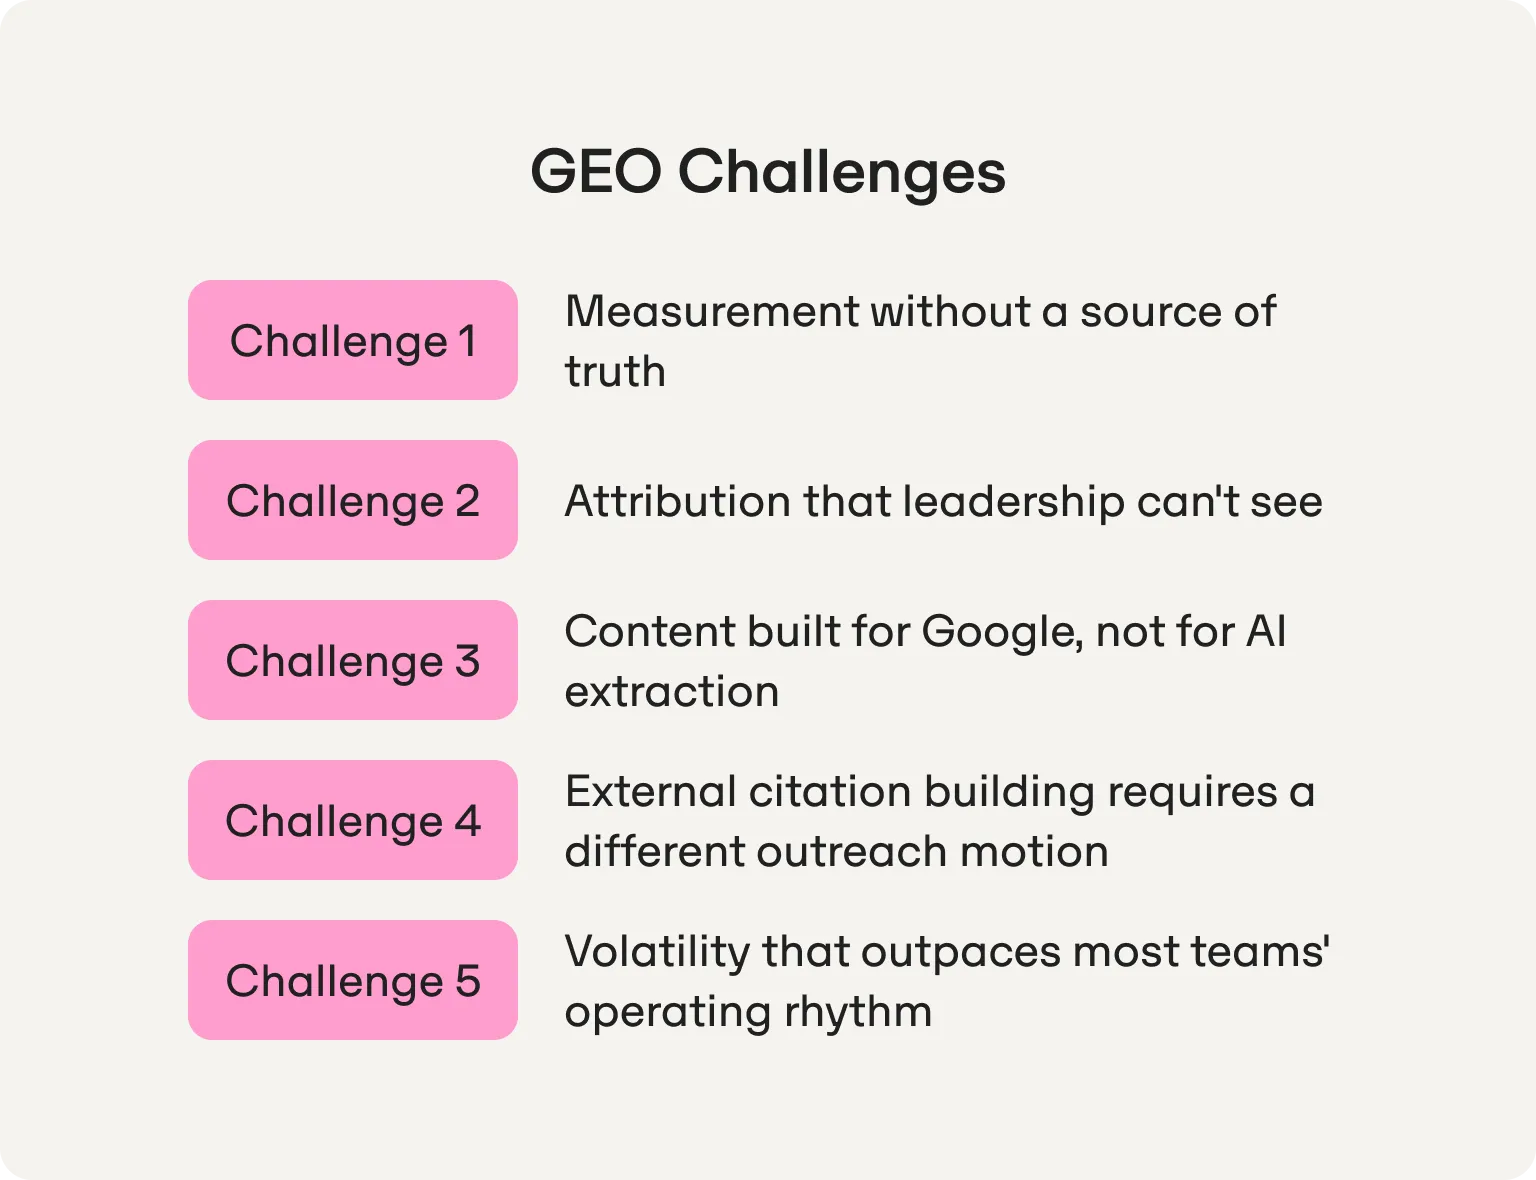
El GEO no es técnicamente complejo. Lo que lo hace difícil es la combinación de una medición probabilística, una atribución invisible, una construcción de citas lenta y un canal que cambia más rápido que los ciclos de informes de la mayoría de los equipos de SEO. Las marcas que se atascan con el GEO no lo hacen porque la estrategia sea errónea, sino porque parten de supuestos de implementación equivocados. Este artículo identifica los cinco retos concretos en los que fallan las implementaciones de GEO, lo que revelan los datos de citas de Omnia sobre cada uno y lo que suponen los últimos cambios de la búsqueda con IA para los equipos que se enfrentan a ellos ahora.
La mayoría de las implementaciones de GEO fracasan en silencio. No con un error visible ni con una decisión clara de abandonar, sino con una deriva lenta que va de «estamos en ello» a «hace tiempo que no miramos esos números» y de ahí a «lo retomamos el trimestre que viene».
La causa rara vez es estratégica. La estrategia suele ser sólida. Lo que falla es la implementación; en concreto, el conjunto de supuestos que los equipos traen del SEO y que no se trasladan al GEO. La cadencia de medición no es la adecuada. Se subestima el alcance de la reestructuración del contenido. El trabajo de citas externas pasa a un segundo plano frente a la publicación. El modelo de atribución se toma prestado de un canal que genera datos de clics y se aplica a uno que no los genera.
Este artículo es para el equipo que ya ha decidido que el GEO importa. Señala los cinco puntos concretos en los que se atascan las implementaciones, lo que revelan los datos propios de citas de Omnia sobre cada reto y lo que exige el panorama actual del GEO a los equipos que de verdad quieren que funcione.
Antes de entrar en los retos, conviene situarse en cómo es hoy el panorama del GEO, porque varios de ellos se están complicando, no simplificando, a medida que madura el canal.
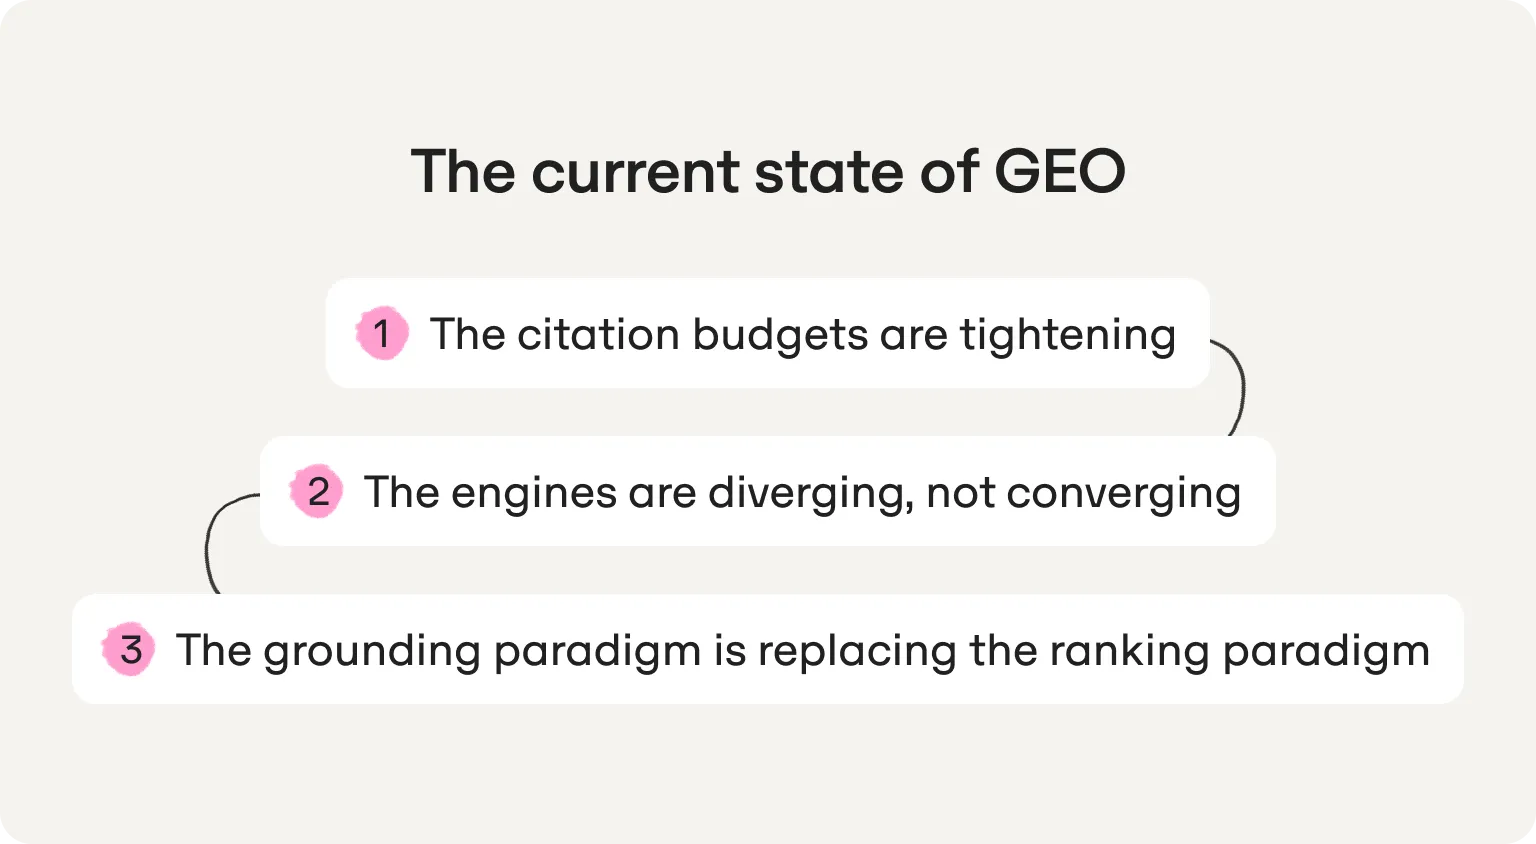
Según la base de datos propia de Omnia, que hace seguimiento de más de 42 millones de citas en cuatro motores de IA, la tendencia es clara: los presupuestos de citas se contraen en dos de los tres grandes motores independientes y se amplían en uno. ChatGPT ofrece de media solo cuatro huecos para citas por respuesta, aproximadamente un 30 % menos que a mediados de 2025. Perplexity ha caído un 36 % desde su máximo de noviembre de 2025. El Modo IA de Google es el único motor en clara expansión: ha crecido un 27 % en cinco meses.
La implicación práctica para la implementación: la ventana para construir autoridad de citas en ChatGPT y Perplexity se está cerrando. Las marcas que todavía no aparecen en esos motores intentan entrar en un sistema más selectivo que el de hace 12 meses. Los equipos que llevan tiempo «pensando en empezar con el GEO» parten de una posición más difícil que los que empezaron a construir autoridad de citas hace un año.
Según los datos de citas de Omnia, analizados por Kevin Indig en su Growth Memo sobre 3,7 millones de citas, solo el 2,37 % de las URL citadas aparece en los tres motores para el mismo prompt. El 91 % aparece en uno solo. El conjunto de fuentes que cita ChatGPT coincide solo en un 50-55 % con el de los motores de Google. Wikipedia se cita 40 veces más en ChatGPT que en los AI Overviews. YouTube domina en los motores de Google y en Perplexity, pero apenas aparece en ChatGPT.
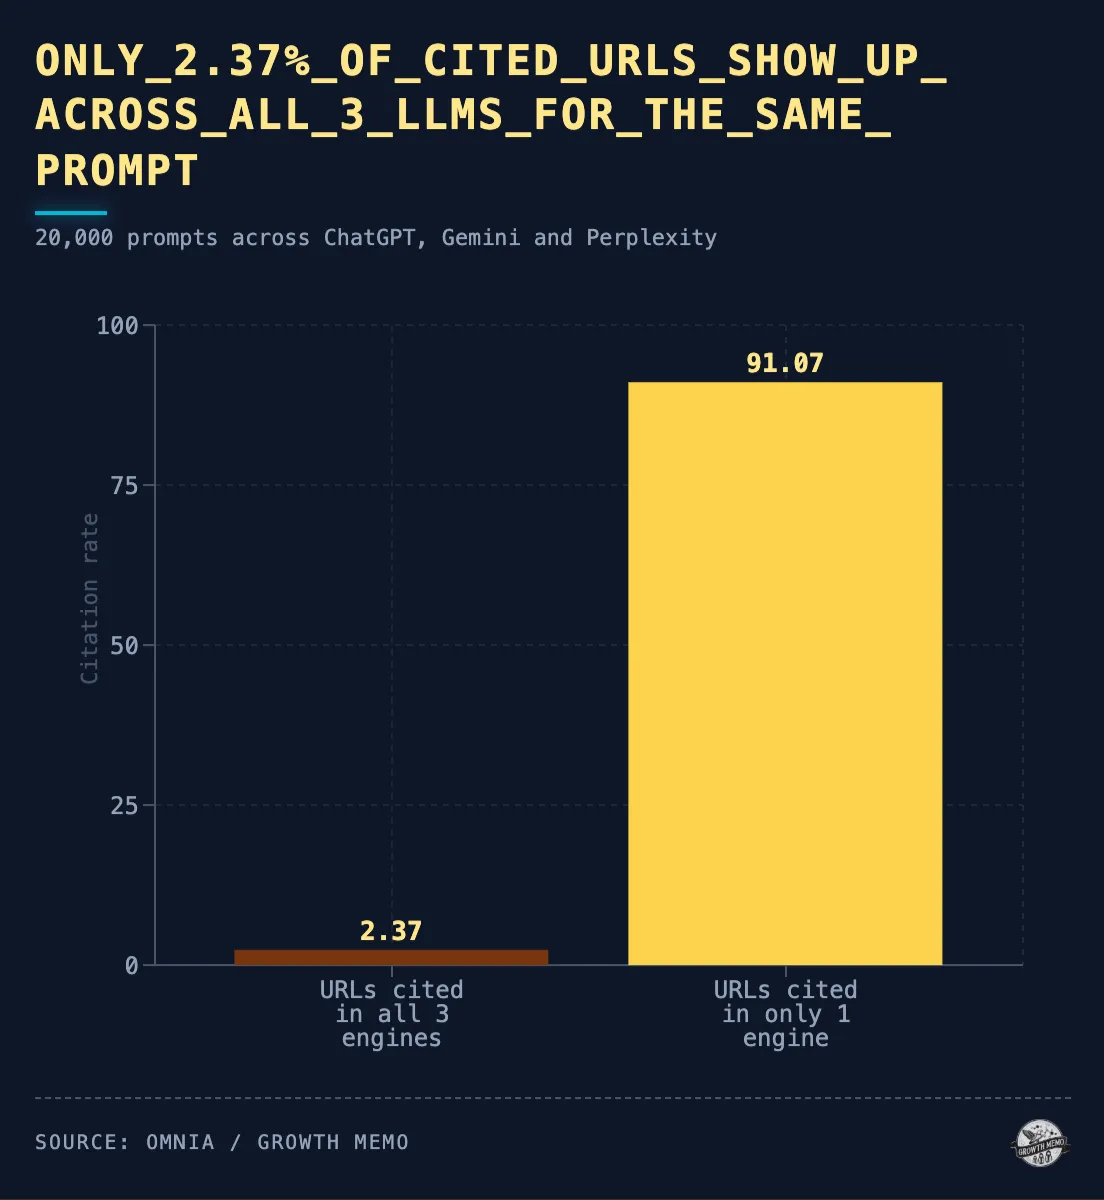
La matriz de optimización multimotor que hace falta para abordar esta divergencia es más compleja que la guía práctica de un solo motor para la que la mayoría de los equipos tiene presupuesto. Una estrategia de contenido y citas pensada para los entornos de Google no te dará visibilidad en ChatGPT. Una estrategia pensada para ChatGPT no se traslada automáticamente al Modo IA. Cada motor necesita un enfoque a medida, lo que multiplica la carga de trabajo de la implementación antes de publicar una sola pieza de contenido.
En mayo de 2026, el equipo de Bing de Microsoft publicó un marco que redefine para qué sirve el índice de búsqueda en la era de la IA, tal como resumió Kevin Indig en el Growth Intelligence Brief #18. El objetivo de optimización ya no es «posicionarse por una palabra clave», sino «ofrecer información en la que fundamentar una respuesta: hechos concretos con una procedencia clara que un modelo pueda citar con responsabilidad». El nuevo embudo de elegibilidad es rastreo, análisis y recuperación, y un fallo en cualquiera de esas fases significa que el contenido no se cita, por bien que se posicione en la búsqueda tradicional.
Los equipos que siguen construyendo su estrategia de GEO en torno a las posiciones de palabras clave están resolviendo el problema equivocado. La guía de optimización para IA que ha publicado Google confirma que la rastreabilidad, la indexabilidad y la exactitud del contenido son los requisitos básicos para sus entornos, y que no hace falta ningún schema ni marcado especial para aparecer en las funciones de IA. El listón ha pasado de la optimización a la elegibilidad, y la mayoría de las implementaciones de GEO no se han puesto al día.
El GEO no tiene un equivalente a Google Search Console. No existe una fuente de datos oficial y en tiempo real que te diga con qué frecuencia aparece tu marca en las respuestas de la IA, qué páginas se citan o cómo te comparas con la competencia en los prompts de tu categoría. Lo que los equipos pueden medir es probabilístico: el mismo prompt genera resultados distintos según la sesión, el usuario, la ubicación y el modo de recuperación.
No es una limitación que vaya a resolver una actualización de plataforma. Es estructural: forma parte de cómo funcionan los motores de IA. Las comprobaciones puntuales de un único prompt no son datos, sino una observación de un sistema probabilístico. Y las cadencias de informes mensuales heredadas del SEO pierden la mayor parte de la señal en un canal en el que los patrones de citas cambian en cuestión de días.
Según los datos de citas de Omnia, ChatGPT cambia su dominio más citado un 92 % de las veces de una semana a otra. Los AI Overviews cambian su dominio más citado un 81,5 % de las veces, lo que los convierte en el motor más estable de los cuatro y en el punto de partida más fiable para los equipos que quieren fijar una línea base para medir el GEO. Hacer seguimiento de las menciones de tu marca y de la competencia en los AI Overviews es la puerta de entrada más accesible a una monitorización sistemática del GEO, precisamente porque ahí la relación señal-ruido es mayor que en ChatGPT. Una volatilidad de la visibilidad de este nivel implica que un informe mensual con una cifra de visibilidad «estable» casi con toda seguridad está promediando variaciones semanales importantes, y algunas de ellas reflejan movimientos reales de la competencia que nadie detectó ni abordó.
La solución no es una herramienta mejor, sino una infraestructura de medición distinta. Cinco métricas forman un sistema fiable de medición del GEO: tasa de menciones, tasa de citas, share of voice, posición en la respuesta y exactitud del relato. Cada una requiere una biblioteca de prompts estructurada, y no pruebas improvisadas, que se ejecute cada semana con medias móviles de cuatro semanas para suavizar la variabilidad de los prompts que hace que los datos de una sesión aislada no sean fiables. El marco completo de KPI y el reparto de responsabilidades se explican en la guía práctica para posicionarse en ChatGPT.
El diagnóstico solo vale si lleva a la acción. Un sistema de medición que genera paneles sin biblioteca de prompts, sin responsables asignados y sin registro de acciones no es un sistema de medición del GEO. Es un simple ejercicio de elaboración de informes.
Las apariciones de marca que genera la IA rara vez producen clics rastreables en la analítica estándar. Un comprador que pregunta a ChatGPT qué herramienta usar, recibe una preselección de tres marcas y visita una de esas webs llega por tráfico directo o por una búsqueda de marca, no por una referencia de IA etiquetada. La contribución del GEO a la decisión de ese comprador es invisible en cualquier conjunto estándar de herramientas de informes.
En Search Engine Land, Jason Barnard lo explica con el concepto de la frontera de delegación (delegation boundary): la línea entre lo que el usuario hace por sí mismo y lo que delega en un motor de IA. A medida que esa frontera se adelanta en el recorrido del comprador, los motores de IA toman decisiones previas: preseleccionan opciones, filtran por criterios y muestran recomendaciones antes de que se produzca ningún evento de tráfico rastreable. Los modelos de atribución basados en eventos de clic pasan por alto toda la decisión que dio forma al conjunto de consideración antes del clic.
Esto crea un problema concreto con la dirección. Cuando un responsable de marketing presenta los resultados del GEO como recuentos de sesiones de GA4, el canal parece invisible. Cuando los presenta como la evolución del share of voice frente a competidores identificados en un conjunto definido de prompts, antes y después de acciones concretas de contenido o de citas, se vuelve comprensible. La prueba del GEO no son los datos de clics. Es el cambio en la visibilidad competitiva en IA a lo largo del tiempo, vinculado a acciones concretas con hipótesis documentadas y fechas para volver a medir.
El enfoque que funciona con la dirección: el GEO mide la presencia de marca en el momento en que se toman decisiones con ayuda de la IA, y se expresa como share of voice, no como tráfico. La metodología para obtener esa prueba, incluida la instantánea del antes y el después a 60 días, se explica en el marco de medición del GEO para equipos que vienen del SEO.
Si tu equipo directivo evalúa el GEO con objetivos de sesiones de GA4, está aplicando a este canal el marco de medición equivocado, y merece la pena replantear qué cuenta como prueba antes de que se juzgue el programa con ese criterio.
La mayoría de los equipos que llegan al GEO tienen una biblioteca de contenido creada para posicionarse por palabras clave: artículos largos estructurados en torno a la intención de búsqueda, encabezados optimizados para fragmentos destacados y estadísticas enterradas en párrafos narrativos. Ese contenido no está preparado para el GEO. La distancia entre lo optimizado para SEO y lo fácil de extraer para la IA es, sistemáticamente, mayor de lo que esperan los equipos de contenido cuando lo auditan por primera vez.
El marco del grounding concreta el problema. Según el marco publicado por el equipo de Bing de Microsoft, tal como lo analizó Kevin Indig en el Growth Intelligence Brief #18, el grounding de la IA exige contenido que supere tres filtros: que se pueda rastrear, analizar y recuperar. La mayoría del contenido SEO falla en el filtro del análisis. Las afirmaciones clave están incrustadas en prosa narrativa en lugar de presentarse como hechos diferenciados y atribuibles. Las definiciones importantes aparecen en mitad de párrafos largos en lugar de como frases independientes que los motores de IA puedan extraer directamente. La tasa de extracción de respuestas (la fiabilidad con la que los motores de IA pueden sacar una afirmación concreta de una página) es baja en la mayoría del contenido creado con criterios SEO, no porque sea malo, sino porque se estructuró para la lectura humana y no para que lo recupere un modelo.
Cuatro cambios de estructura cierran la brecha sin rehacer todo el contenido: una declaración de entidad en el primer párrafo que defina qué es tu marca, a quién se dirige y qué problema resuelve; estadísticas presentadas como afirmaciones independientes y atribuibles, con la fuente citada y un enlace directo, en lugar de incrustadas en la prosa; respuestas directas a preguntas concretas en las primeras 300 palabras, antes de desarrollar el contexto; y firmas de autor, fechas de publicación y enlaces visibles a las fuentes como señales de procedencia que permiten a los motores de IA atribuir las afirmaciones con responsabilidad. El marco de brief de contenido de la guía para pequeñas empresas explica cada elemento en detalle.
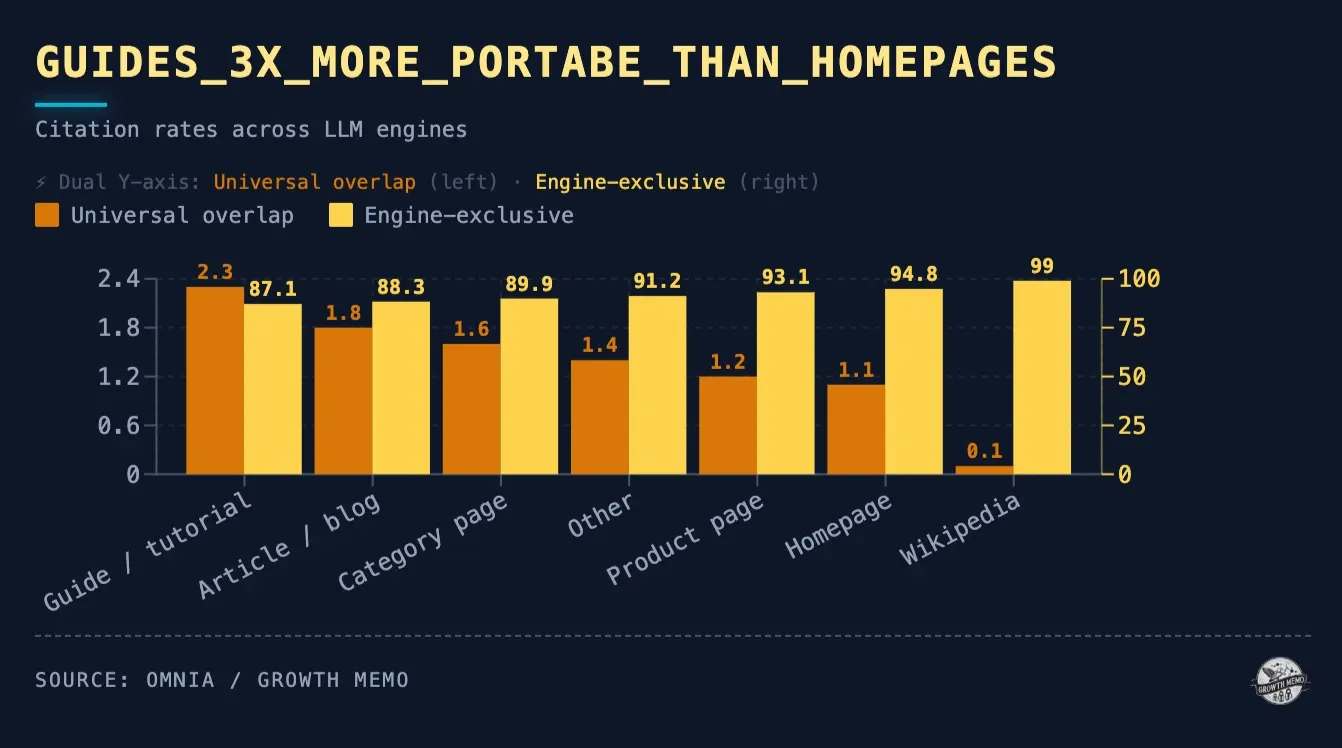
Según los datos de citas de Omnia, analizados en el Growth Memo de Kevin Indig sobre 4,1 millones de apariciones de URL, las guías y los tutoriales logran un 2,3 % de coincidencia entre motores, frente a solo un 1,1 % de las páginas de inicio. El formato que los equipos de SEO suelen relegar, el contenido explicativo y organizado en torno a preguntas, es el que mejor se cita en todos los motores de IA. El contenido que los equipos de SEO más se esfuerzan en optimizar (páginas de producto, páginas de inicio y landing pages comerciales) es el formato menos citable en las respuestas de la IA para prompts comerciales.
Reestructurar el contenido no es un sprint puntual. Es un listón de calidad permanente, y el problema crece con cada pieza que se publica con una estructura inadecuada.
Es el reto que la mayoría de los equipos descubre demasiado tarde: después de tres meses publicando contenido con constancia sin que se mueva la tasa de menciones.
La autoridad de citas en GEO se construye sobre las fuentes en las que confían los motores de IA para tu categoría: plataformas de reseñas, directorios del sector, publicaciones editoriales y sitios de comunidad que aparecen de forma constante en las respuestas de la IA para tus prompts objetivo. No son las mismas fuentes a las que apuntan las campañas de link building del SEO. Requieren otro enfoque de contacto con medios: crear perfiles en plataformas de reseñas en lugar de conseguir enlaces, apariciones editoriales que aporten autoridad en lugar de guest posting para sumar backlinks, e inclusión en directorios o en informes de analistas en lugar de perseguir autoridad de dominio.
Según los datos de citas de Omnia en categorías de prompts comerciales, las fuentes de terceros dominan sistemáticamente las citas de ChatGPT frente a los blogs de los proveedores en prompts de tipo «mejores» y «alternativas». Las menciones propias frente a ganadas se comportan de forma distinta en GEO que en SEO: el contenido propio (tu blog, tu web) es necesario para la elegibilidad técnica, pero no basta para tener autoridad de citas en contextos comerciales. La presencia ganada en fuentes en las que los motores de IA ya confían es la palanca principal, y es la que la mayoría de los equipos deja para más tarde porque se parece menos a «trabajo de contenido».
El patrón de fallo concreto: equipos que empiezan por crear contenido porque parece productivo y descubren entre seis y ocho semanas después que la tasa de menciones no se ha movido. No porque el contenido fuera malo, sino porque la confianza de cita de su propio dominio nunca fue lo bastante alta. El diagnóstico es sencillo: si tu tasa de menciones sigue plana tras seis semanas publicando contenido con constancia, el problema casi con toda seguridad está en las citas externas, no en la calidad del contenido.
El enfoque de citas externas en tres frentes (presencia en plataformas de reseñas, cobertura editorial en las publicaciones que los motores de IA citan para tu categoría e inclusión en directorios o en informes de analistas) se explica en detalle en la guía completa de GEO. El punto de partida siempre es la inteligencia de citas: identificar qué dominios concretos aparecen cuando los motores de IA recomiendan a tu competencia en tu categoría, antes de decidir dónde construir presencia.
ChatGPT ofrece de media cuatro huecos para citas por respuesta, y la cifra va a la baja. Cada hueco que ocupa un competidor a través de una fuente externa de confianza es un hueco que tu marca no puede ocupar. La saturación competitiva en IA en las categorías con muchas citas es real y va a más. Construir citas externas es desplazar a la competencia, y los equipos que empiecen más tarde pagarán un precio de entrada más alto.
El GEO se mueve más rápido que el SEO en todas las dimensiones que importan para la implementación.
Los patrones de citas cambian en días, no en meses. El contenido de las respuestas varía entre sesiones del mismo día. Los presupuestos de citas bajan en dos de los tres grandes motores. Las posiciones competitivas en las citas pueden cambiar mucho en una sola semana. Y la variación geográfica de los patrones de citas hace que la visibilidad en IA de una marca en EE. UU. y en el Reino Unido pueda divergir de forma notable en la misma semana sin que la marca ni su competencia hayan hecho nada.
Según la base de datos de citas de Omnia: la estabilidad de las citas de ChatGPT es del 8,1 % de una semana a otra, es decir, el dominio más citado cambia un 92 % de las veces. Los AI Overviews son más estables, con un 18,5 %, pero aun así cambian su dominio más citado más del 80 % de las semanas. El presupuesto de citas de Perplexity ha caído un 36 % desde su máximo de noviembre de 2025. Estas cifras describen un canal que exige medición semanal, revisión estratégica mensual y auditorías de entidad trimestrales, no los ciclos de informes trimestrales y los calendarios de contenido anuales con los que funcionan la mayoría de los programas de SEO.
Los desajustes operativos concretos entre los ritmos habituales del SEO y lo que exige el GEO:
El ritmo operativo mínimo viable del GEO: una ejecución semanal de 30 minutos de la biblioteca de prompts sobre tus grupos de prompts comerciales clave, una auditoría mensual de las fuentes de citas para detectar qué dominios nuevos han entrado en la huella de citas de tu categoría, una revisión trimestral de la exactitud de la entidad para confirmar que los motores de IA describen bien tu marca, y un registro de acciones que vincule cada señal observada con una hipótesis concreta, una acción definida, una fecha límite y un resultado documentado.
El impacto de la variabilidad de los prompts hace que una anomalía de una sola semana no sea una señal, sino ruido. Una tendencia a la baja durante cuatro semanas sí es una señal. El objetivo operativo es una cadencia de medición lo bastante rápida para detectar movimientos reales antes de que se acumulen, y lo bastante disciplinada para no reaccionar a cada fluctuación entre sesiones. La cadencia completa de pruebas y el reparto de responsabilidades se explican en la guía práctica para posicionarse en ChatGPT.
La volatilidad no es motivo para evitar el GEO. Es el motivo para montar una monitorización sistemática antes de crear contenido, porque sin ella no puedes distinguir una caída real de la visibilidad de la variabilidad normal de los prompts, ni vincular tus acciones de contenido o de citas con los cambios de visibilidad que realmente produjeron.
Los cinco retos anteriores son reales. También se pueden superar, y lo que hace que una implementación funcione se repite en todas las marcas que lo han conseguido.
Según los datos de citas de Omnia y los resultados que se observan en su base de clientes, las implementaciones de GEO que logran resultados medibles en un plazo de 60 a 90 días comparten tres características: empiezan por la inteligencia de citas en lugar de por la producción de contenido, miden cada semana frente a un mapa de cobertura de prompts definido desde el primer día y se centran en un conjunto reducido de cinco a diez prompts en lugar de intentar cubrir toda la categoría.
PuntoSeguro, una distribuidora española de seguros de vida con una plantilla de 10 personas, se convirtió en tres meses en la marca de seguros de vida n.º 1 de España en los motores de IA, por delante de grandes compañías con 300 veces su presupuesto. Su esfuerzo semanal: un artículo nuevo y tres o cuatro existentes actualizados. El resultado no vino del volumen de contenido, sino de construir citas de forma selectiva en las fuentes concretas en las que confían los motores de IA para los prompts sobre seguros de vida en España.
Iberia Cards consiguió +18 puntos porcentuales frente a su principal competidor en consultas de importancia estratégica y la posición n.º 1 en los cinco prompts clave sobre Avios en todos los motores de IA monitorizados. El resultado no vino de publicar más contenido, sino de identificar qué fuentes concretas citaban los motores de IA para los prompts de alta intención sobre Avios y redirigir su inversión actual en contenido para ajustarse a esos patrones de citas.
El patrón en ambos casos es idéntico: la implementación funcionó porque empezó por la inteligencia de citas en lugar de por la producción de contenido. Primero se diagnosticó la brecha de citas. Las acciones de contenido y de contacto con medios siguieron a los datos. El sistema de medición ya estaba en marcha antes de dar el primer paso.
Los cinco retos anteriores exigen cinco capacidades concretas: no una plataforma genérica de visibilidad en IA, sino un sistema diseñado en torno a los fallos específicos con los que se topan en la práctica las implementaciones de GEO.
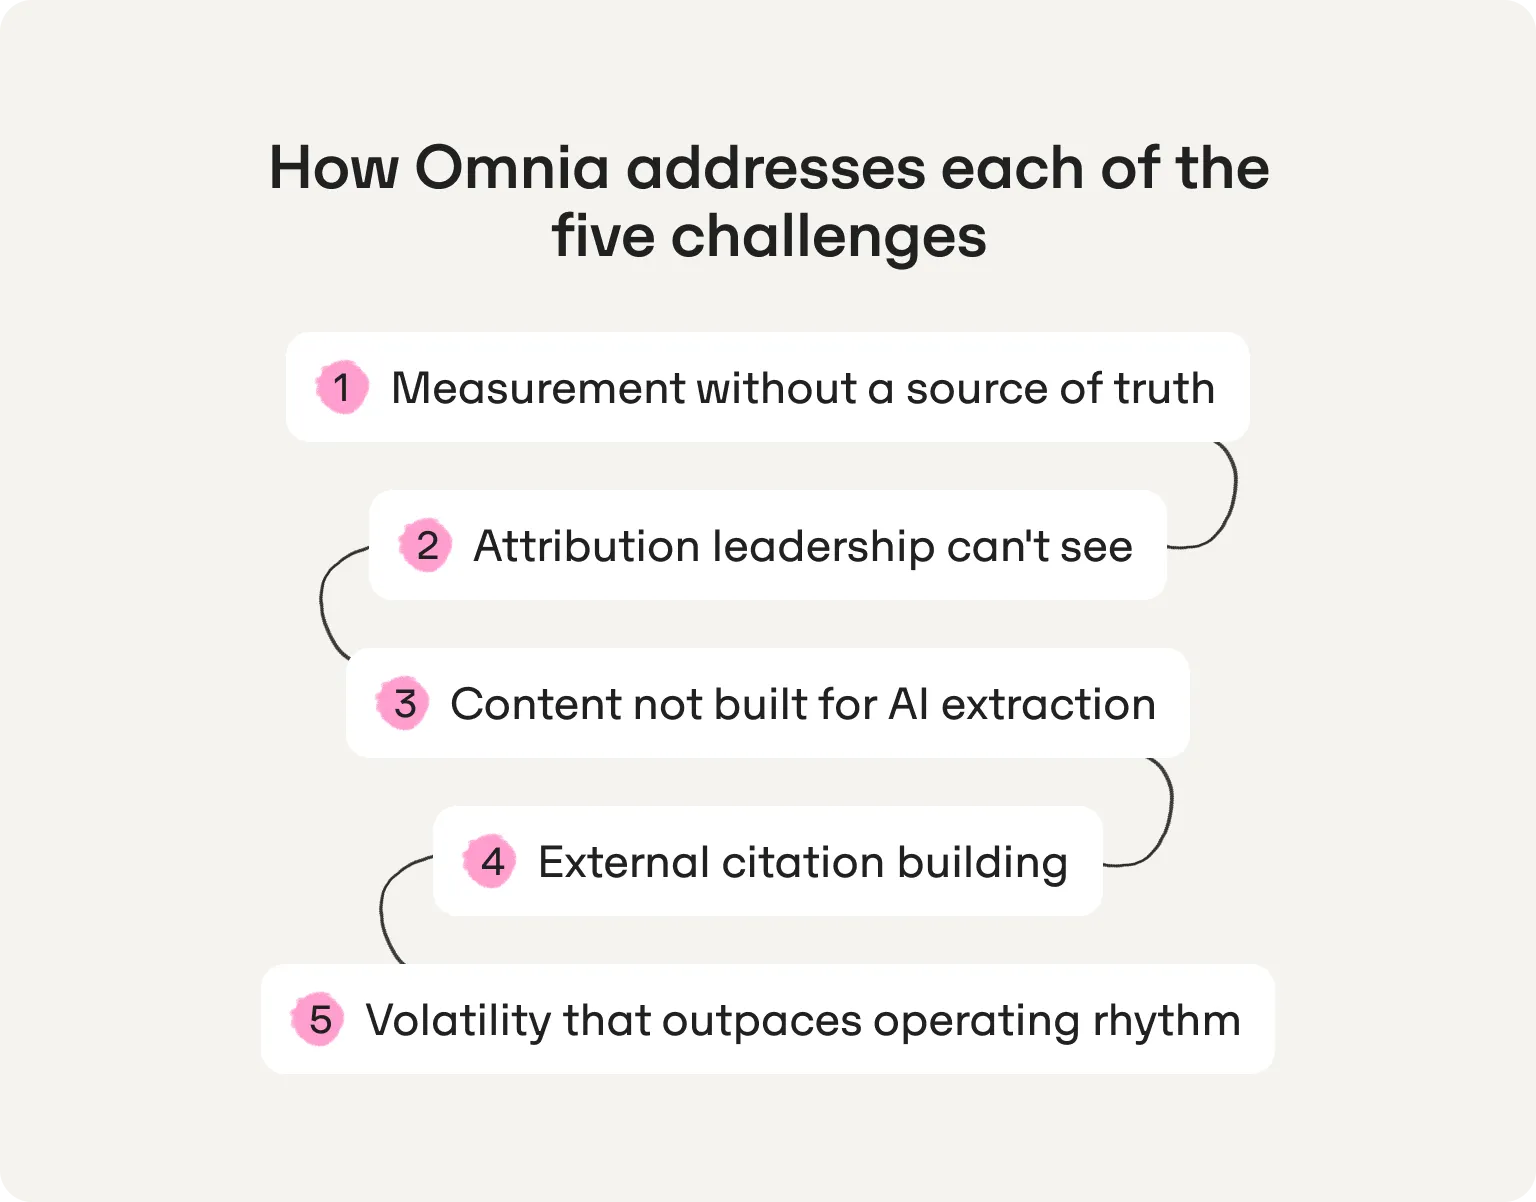
Medir sin una fuente única de verdad: Omnia hace seguimiento a diario de la presencia de tu marca en ChatGPT, Perplexity, los AI Overviews de Google y el Modo IA, y mide la tasa de menciones, la tasa de citas, el share of voice y la posición en la respuesta por motor y por mercado. Los datos de tendencia semanales sustituyen al ruido de comprobar prompts a mano, sesión a sesión. El AI Visibility Score ofrece a la dirección una única métrica compuesta para informar de la tendencia general, sin perder el detalle por motor que guía las decisiones tácticas.
Una atribución que la dirección no ve: la metodología de instantáneas del antes y el después de Omnia hace seguimiento de la evolución del share of voice frente a competidores identificados en un conjunto definido de prompts, vinculada a acciones concretas de contenido y de citas con hipótesis documentadas y fechas para volver a medir. El marco de atribución se basa en lo que el GEO puede demostrar de verdad: movimientos de visibilidad, no datos de clics.
Contenido no pensado para que la IA lo extraiga: la inteligencia de citas de Omnia muestra qué páginas y dominios concretos citan los motores de IA en tu categoría para cada prompt objetivo, y genera una lista de prioridades de reestructuración basada en el comportamiento real de las citas, no en una auditoría de contenido genérica guiada por señales de SEO.
Construcción de citas externas: el análisis de citas por prompt de Omnia identifica los dominios exactos que generan citas para cada uno de tus grupos de prompts objetivo. Así elimina las conjeturas a la hora de priorizar el contacto con medios y te dice en qué dos o tres fuentes externas centrarte antes de publicar otra pieza de contenido.
Una volatilidad que supera tu ritmo de trabajo: la monitorización semanal de prompts y el seguimiento de tendencias con medias móviles de Omnia convierten la volatilidad en una señal, en lugar de un lastre. Los cambios en los patrones de citas que pasarían desapercibidos en un informe mensual aparecen como movimientos de tendencia semanales, con tiempo suficiente para actuar antes de que la competencia consolide su ventaja. El flujo de monitorización de IA funciona en segundo plano para que tu equipo dedique su tiempo a actuar, no a comprobar prompts a mano.
Empieza tu prueba gratuita de 14 días con el plan Growth → Sin tarjeta de crédito.
Omnia ofrece una prueba gratuita de 14 días con el plan Growth.
Sin tarjeta de crédito. Descubre exactamente dónde aparece tu marca (y dónde no) en los motores de IA y deja que las recomendaciones de la plataforma te marquen el siguiente paso.

Las cinco barreras de implementación más habituales son: medir sin una fuente única de verdad fiable, una atribución que la analítica estándar no puede captar, bibliotecas de contenido creadas para Google y no para que la IA las extraiga, una construcción de citas externas que exige un enfoque de contacto con medios distinto del link building del SEO y una volatilidad del canal que supera la cadencia de informes y de trabajo de la mayoría de los equipos. La mayoría de las implementaciones se atascan no porque la estrategia sea errónea, sino porque uno o varios de estos supuestos heredados del SEO no se trasladan al GEO.
El SEO produce resultados deterministas: una palabra clave tiene una posición en la SERP observable y lo bastante estable como para seguirla cada mes. El GEO produce resultados probabilísticos: el mismo prompt genera respuestas distintas según la sesión, el usuario, la ubicación y el modo de recuperación. No existe un equivalente de Google Search Console para el GEO. Para medirlo de forma fiable hace falta una biblioteca de prompts estructurada que se ejecute cada semana sobre un conjunto estable de prompts comerciales, con medias móviles de cuatro semanas para suavizar la variabilidad entre sesiones. Las comprobaciones puntuales de una sola sesión generan ruido, no datos de tendencia.
Construir citas en fuentes externas en las que los motores de IA ya confían (plataformas de reseñas, directorios del sector, publicaciones editoriales) puede mover de forma medible la tasa de menciones en un plazo de dos a cuatro semanas. Las mejoras que dependen del contenido tardan más: normalmente de seis a ocho semanas hasta que los motores de IA incorporan de forma constante el contenido nuevo a sus patrones de citas. Las implementaciones que dan resultados más rápido empiezan por las citas externas, no por la creación de contenido, porque el verdadero cuello de botella casi siempre es la brecha de citas externas, no la calidad del contenido.
El posicionamiento en Google y las citas en IA funcionan con mecanismos distintos. Los motores de IA deciden si una fuente es elegible para citarla según su autoridad en plataformas externas de confianza, la estructura del contenido para que la IA pueda extraerlo y la coherencia de la entidad en toda la web, no según la autoridad en palabras clave ni el perfil de backlinks. Una página que sale en la primera página de Google puede incumplir a la vez los tres criterios de elegibilidad de la IA. La causa más habitual es el fallo de interpretación: contenido técnicamente accesible pero con una estructura opaca, con las afirmaciones clave enterradas en prosa narrativa en lugar de presentadas como hechos diferenciados y fáciles de extraer. La segunda causa más habitual es la brecha de citas externas: el dominio de la página no tiene presencia en las fuentes de terceros en las que confían los motores de IA para los prompts comerciales de esa categoría.
Hay tres señales de que una implementación se está atascando. La primera, una tasa de menciones plana tras seis semanas publicando contenido con constancia, lo que casi siempre indica un problema de citas externas y no de calidad del contenido. La segunda, una tasa de menciones al alza con una tasa de citas plana, lo que indica que el reconocimiento de la entidad se está formando, pero la autoridad de la fuente todavía no ha alcanzado el umbral para que se cite directamente su URL. La tercera, una variación importante de los resultados según el motor, lo que indica una estrategia optimizada para un solo motor en lugar de un enfoque multimotor y significa que la visibilidad en un motor está ocultando la invisibilidad en los demás.
Sí, en dos de los tres grandes motores independientes. Según los datos propios de citas de Omnia, el presupuesto de citas de ChatGPT ha caído aproximadamente un 30 % desde mediados de 2025, y el de Perplexity ha bajado un 36 % desde su máximo de noviembre de 2025. Ambos motores se están concentrando en fuentes de mayor autoridad. La oportunidad está en el Modo IA de Google, que ha crecido un 27 % en el mismo periodo: cita muchas más fuentes por respuesta que ChatGPT y sus patrones de citas todavía están menos consolidados. La ventana para ganar autoridad de citas en ChatGPT y Perplexity se está cerrando. La del Modo IA es, ahora mismo, la más abierta de los cuatro grandes motores.
Escrito por
 JoseGrowthenOmniaJoseGrowthenOmnia
 Miguel FernándezCTO y fundadorenOmnia
 JoseGrowthenOmnia
 El equipo de Omnia
 El equipo de Omnia
Sin tarjeta de crédito · Gratis durante 14 días · Descubre tu visibilidad en IA en 3 minutos