Visibilidad en búsquedas con IA
Cómo convertir tus datos de visibilidad en IA en una hoja de ruta de GEO en 2026

 JoseGrowthenOmnia
 AndreiHead of GrowthenOmnia
En resumen
Para aprender a posicionarte en la búsqueda de ChatGPT, primero tienes que aceptar que no existe una posición n.º 1 fija: solo hay tasa de menciones, tasa de citas y share of voice (SOV) en un conjunto de prompts definido. Empieza por comprobar que tus páginas se pueden rastrear y están indexadas, aplica ingeniería inversa para descubrir desde qué dominios se cita a tu competencia y mide tu visibilidad cada semana por grupo de prompts y por país. El resto de esta guía práctica te enseña a hacer funcionar ese sistema de forma repetible y qué herramienta convierte ese ejercicio manual en un ciclo de feedback automatizado.
La mayoría de los consejos sobre «cómo posicionarse en ChatGPT» son SEO tradicional reempaquetado con terminología nueva. Optimiza tu contenido, consigue backlinks, mejora tu puntuación E-E-A-T… y espera. Eso no es una estrategia de visibilidad en ChatGPT. Es una estrategia de SEO con aspiraciones.
ChatGPT no mantiene una lista ordenada de resultados. Sintetiza respuestas a partir de un conjunto de fuentes pequeño y selectivo y, según la base de datos propia de citas de Omnia, que registra más de 42 millones de citas, ese conjunto se reduce de media a solo cuatro dominios por respuesta de ChatGPT. Es tres veces más selectivo que el Modo IA de Google. Conseguir que ChatGPT te cite no es un problema de posicionamiento. Es un problema de elegibilidad y autoridad, y exige un sistema de medición distinto del que usan hoy la mayoría de los estrategas de SEO.
Esta guía práctica te da ese sistema: una arquitectura de biblioteca de prompts, un marco de medición repetible, una base técnica de siete pasos y un análisis honesto de lo que puedes controlar y lo que el modelo decide por su cuenta.
No existe una posición universal en una respuesta de ChatGPT. Las respuestas varían según el usuario, el país, el modo de recuperación y la formulación concreta del prompt. Dos personas que hacen la misma pregunta en mercados distintos pueden recibir preselecciones sustancialmente diferentes. Una sola ejecución de un prompt no te dice nada fiable sobre tu visibilidad real en ChatGPT.
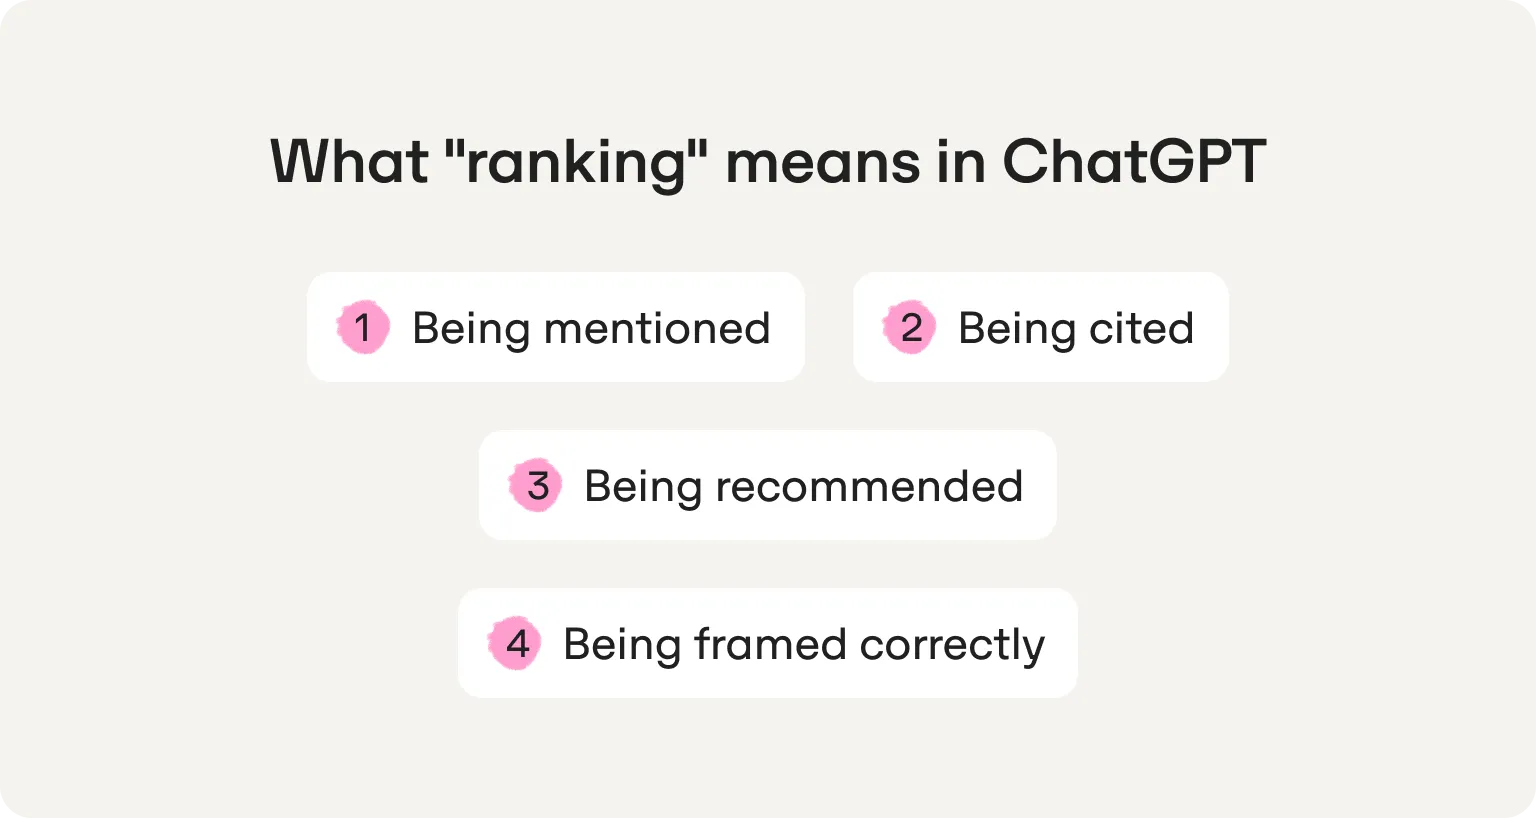
Lo que sí puedes medir —y lo que de verdad significa «posicionarse» en este contexto— se divide en cuatro categorías operativas:
El problema para los estrategas de SEO: nada de esto lo recogen las herramientas tradicionales de seguimiento de posiciones, las herramientas de palabras clave ni los paneles de tráfico. Necesitas otra capa de medición.
El SEO tradicional es determinista. Una palabra clave tiene una SERP. Una página ocupa una posición. Un cambio de posición se puede observar y atribuir. ChatGPT es probabilístico. El mismo prompt produce resultados distintos según la sesión, el usuario, la geografía y el modo de recuperación.
Dos ejemplos concretos lo dejan claro.
Una consulta por la palabra clave «mejor software de gestión de proyectos» genera una SERP de Google relativamente estable que las herramientas de SEO pueden seguir. La misma pregunta, formulada como prompt en ChatGPT, genera una respuesta sintetizada que puede nombrar a tres proveedores distintos según si el usuario está en EE. UU. o en el Reino Unido, qué índice de recuperación estaba activo y qué fuentes recuperó ChatGPT en esa sesión.
Una consulta como «cómo migro datos de Salesforce a HubSpot» genera una SERP de Google en la que las páginas de documentación y las guías prácticas compiten por autoridad de backlinks y optimización de palabras clave. El mismo prompt en ChatGPT genera una respuesta sintetizada a partir de las fuentes que ChatGPT considera con más autoridad, que suelen ser publicaciones editoriales, directorios comparativos y plataformas de comunidad antes que el blog del propio proveedor.
Lo que puedes controlar: la estructura del contenido, la accesibilidad técnica, la coherencia de la entidad y la presencia en fuentes externas. Lo que no puedes controlar: el comportamiento del modelo, los efectos de la personalización y los sesgos previos del entrenamiento que no ves. Esta guía se centra exclusivamente en lo que se puede controlar.
ChatGPT responde a partir de dos fuentes a la vez: los datos de entrenamiento incorporados durante el desarrollo del modelo y la recuperación en tiempo real de índices de búsqueda cuando la función de «búsqueda» está activa. El equilibrio entre ambas depende del tipo de consulta y de la versión de ChatGPT que use cada persona.
En las experiencias de ChatGPT con la búsqueda activada —las que importan para la visibilidad de marca y los prompts comerciales—, la capa de recuperación de la IA determina qué fuentes se descargan, se analizan y aparecen en la respuesta. Después, el modelo sintetiza esas fuentes en una respuesta y cita de forma selectiva las que considera más creíbles y más relevantes para la pregunta concreta.
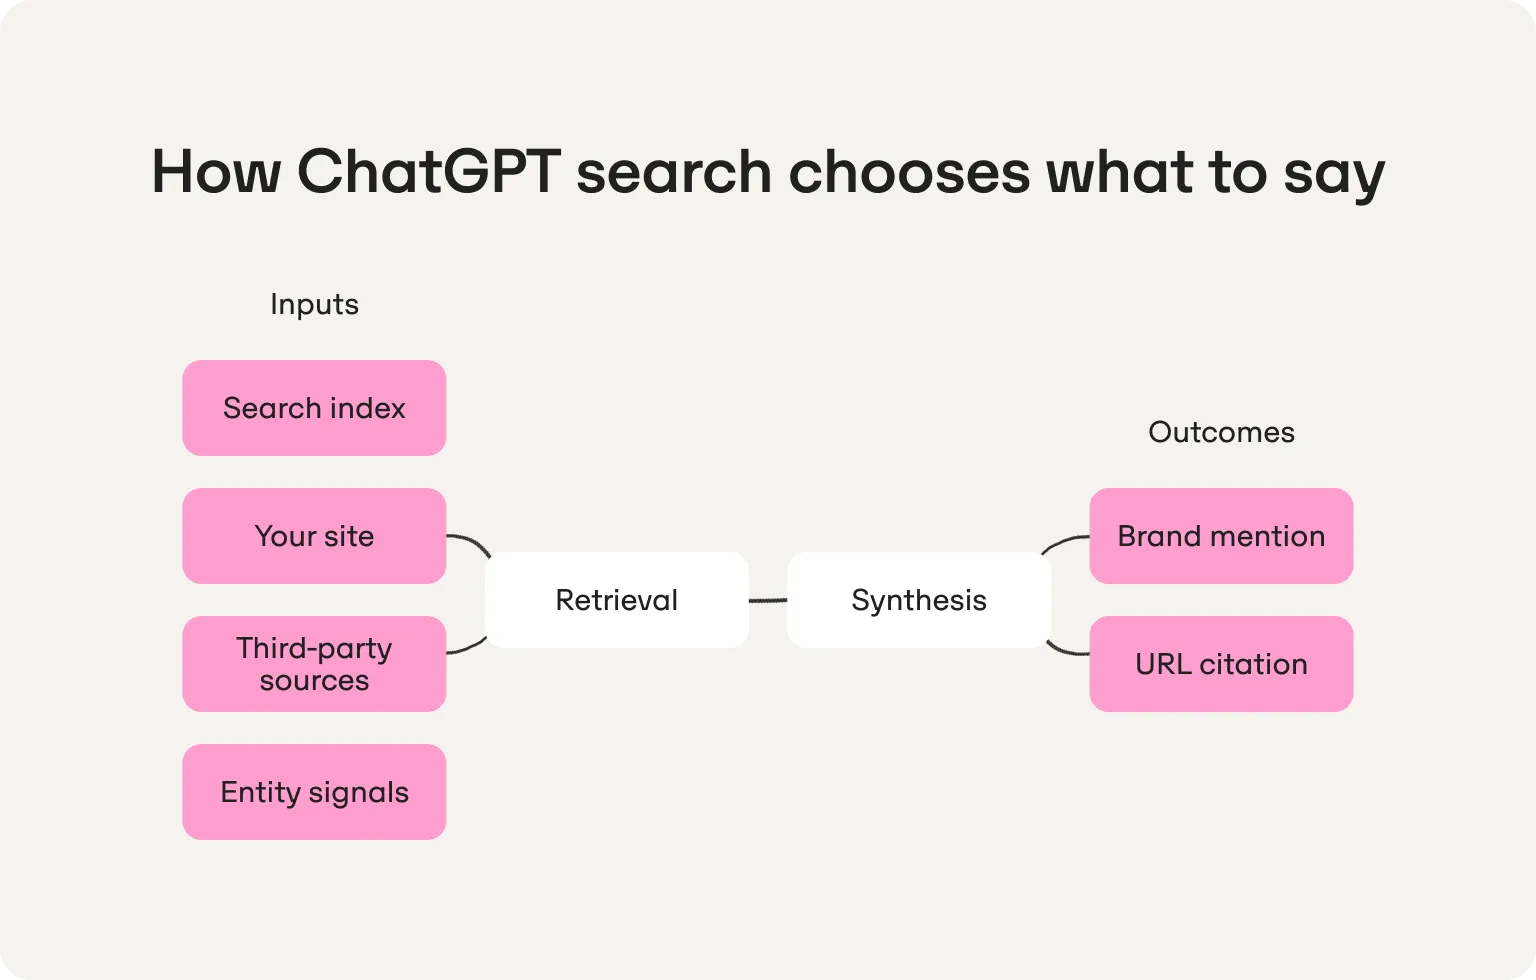
Una mención sin URL significa que el modelo incluye tu marca en la respuesta, pero no ha usado una página concreta como fuente. Es útil para el descubrimiento de marca, porque los compradores ven tu nombre, pero no aporta una señal de tráfico verificable ni refuerza tu autoridad como fuente.
Una cita con URL significa que el modelo ha recuperado tu contenido directamente y ha decidido mostrarlo como referencia. Esto genera tráfico de referencia que puedes medir e indica que tu contenido cumple los criterios de elegibilidad que aplica el modelo al seleccionar fuentes.
Mide ambas. La tasa de menciones te dice si tu marca se reconoce como entidad. La tasa de citas te dice si tu contenido inspira confianza como fuente. Una tasa de menciones que sube con una tasa de citas estancada —un patrón habitual— indica que el reconocimiento de la entidad se está formando, pero que la autoridad como fuente sigue siendo insuficiente. Esa es la brecha que cierran el contenido estructurado, la coherencia de la entidad y las citas que consigues fuera de tu web.
Lo que es fiable: los resultados de prompts registrados con el texto capturado, las URL y los dominios citados que observas, el tráfico de referencia etiquetado como procedente de fuentes de IA en tu herramienta de analítica, el estado de indexación en las herramientas para webmasters de los buscadores y las tasas de menciones y de citas medidas de forma coherente en un conjunto de prompts definido.
Lo que es orientativo: cualquier «posición» real en sentido estático, los efectos de la personalización en sesiones individuales y los sesgos previos del modelo, procedentes de datos de entrenamiento que no puedes inspeccionar. Trátalos como señales, no como hechos.
Antes de cualquier optimización estratégica, el requisito previo es confirmar que la función de búsqueda de ChatGPT puede encontrar y recuperar tu contenido. ChatGPT con la búsqueda activada se nutre del índice de Bing. Si tus páginas no están indexadas ahí, no pueden recibir citas, por muy bien que funcionen en Google.
La lista de comprobación antes de empezar a optimizar:
Bing no es ChatGPT. El modelo tiene su propia lógica de recuperación, su propia comprensión de las entidades y su propia forma de sintetizar. Pero la indexación en Bing es la puerta de acceso. Sin ella, tu contenido no se puede recuperar.
Los aspectos básicos operativos, sin caer en el SEO genérico:
Asegúrate de que tus páginas son indexables y no tienen conflictos de canonicalización. Una página que declara como canónica una URL distinta de la que Bing tiene indexada genera confusión en la recuperación: el modelo puede descargar una versión y citar otra. Sitemaps XML limpios, un renderizado HTML rápido y la ausencia de bloqueos accidentales en el robots.txt son las condiciones mínimas. Las páginas que las cumplen son elegibles. Las que no, son invisibles por bueno que sea su contenido.
Algunas respuestas de ChatGPT usan la recuperación en tiempo real de índices de búsqueda y fuentes externas. Que tu contenido entre en esa recuperación depende de la elegibilidad: la combinación de indexabilidad, accesibilidad, claridad estructural y autoridad de la fuente. El comportamiento del modelo no se puede controlar. Que tu contenido se pueda recuperar y esté bien estructurado, sí. Estos siete pasos son la base operativa que tiene que estar lista antes de que las mejoras estratégicas o de medición den resultados estables.
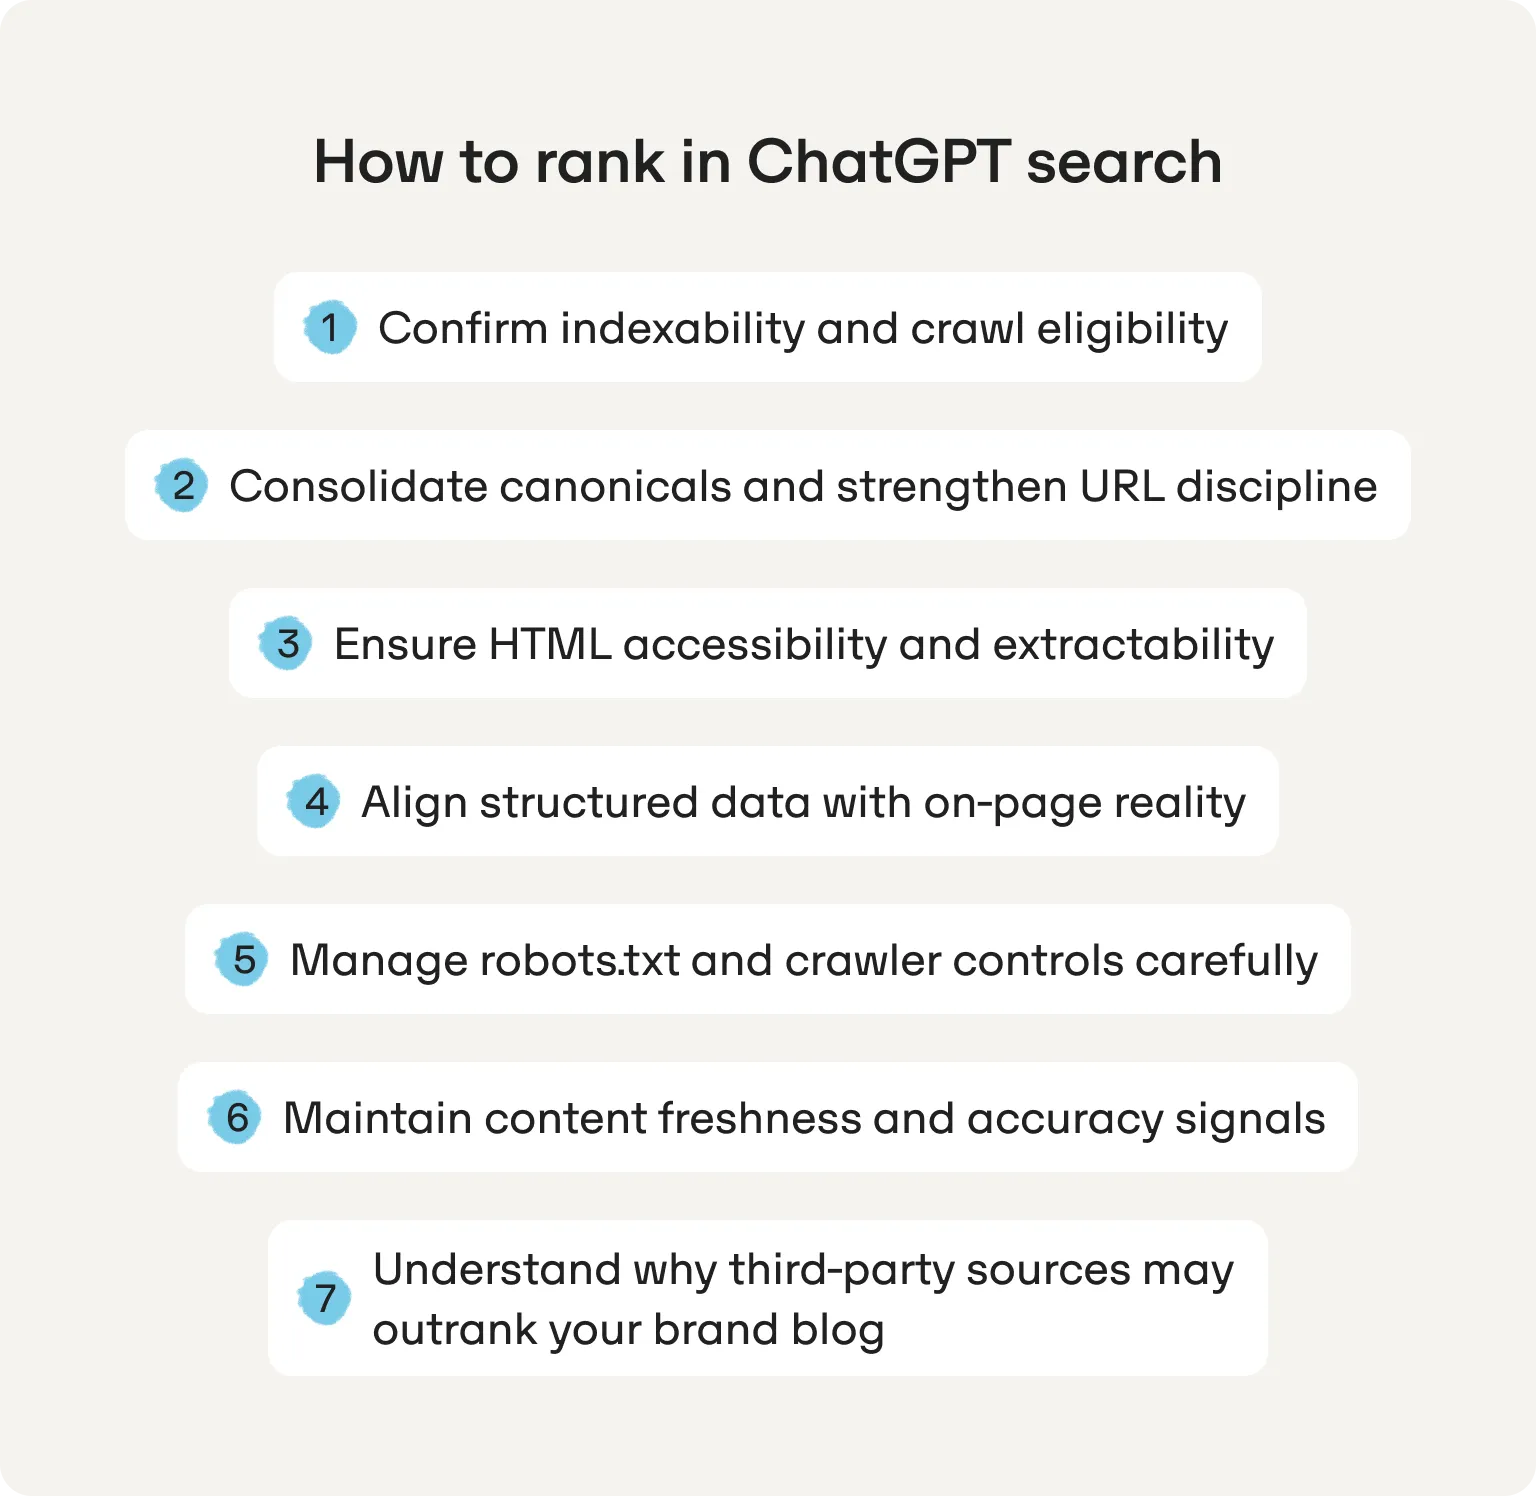
Plantéalo como una validación de la elegibilidad antes de optimizar. Una página que falla aquí está fuera del juego, por bien escrita que esté.
Los criterios de inclusión en respuestas —las condiciones que una página tiene que cumplir para que se la considere como fuente— empiezan aquí. La elegibilidad es el requisito previo. Todo lo demás es optimizar una página que ya es elegible.
La dilución de señales es el coste oculto de las estructuras de URL fragmentadas. Cuando varias páginas tratan prompts parecidos con contenido que se solapa, los sistemas de recuperación no pueden identificar qué URL lleva la señal de autoridad.
Consolidar no reduce la amplitud del contenido: concentra la claridad para la recuperación, de modo que el modelo sepa qué página usar cuando se ejecuta un prompt relevante.
La prioridad de recuperación depende en parte de lo fácil que le resulte a un modelo analizar tu contenido. Las páginas que renderizan el contenido principal con JavaScript que los rastreadores de IA no ejecutan son, en la práctica, invisibles para la capa de recuperación, aunque se posicionen en Google.
Google ha confirmado que no hace falta ningún schema especial para aparecer en sus funciones de IA, incluidos los AI Overviews y el Modo IA. El schema no activa citas. Es una señal de claridad de la entidad: ayuda a los modelos a entender qué es tu marca, qué hace y cómo se relaciona con la categoría en la que opera.
Dónde aporta valor el schema:
Regla crítica: los nombres del schema deben coincidir exactamente con el contenido visible de la página. Si lo que declara el schema no coincide con el texto de la página, se genera confusión sobre la entidad. El modelo puede citar una versión de la descripción de tu producto mientras tu schema declara otra.
El archivo robots.txt controla el acceso de los rastreadores. No elimina de forma retroactiva el contenido que ya se ha incorporado a los datos de entrenamiento del modelo. Los cambios en el robots.txt afectan a la rastreabilidad futura, no al conocimiento histórico del modelo.
Permite el acceso a todo el contenido público. Bloquea los directorios de administración, autenticación, preproducción y búsqueda interna. Coordina cualquier cambio importante en el robots.txt con ingeniería y con el equipo legal: los bloqueos accidentales en páginas comerciales son una causa habitual e invisible de pérdida de elegibilidad para las citas.
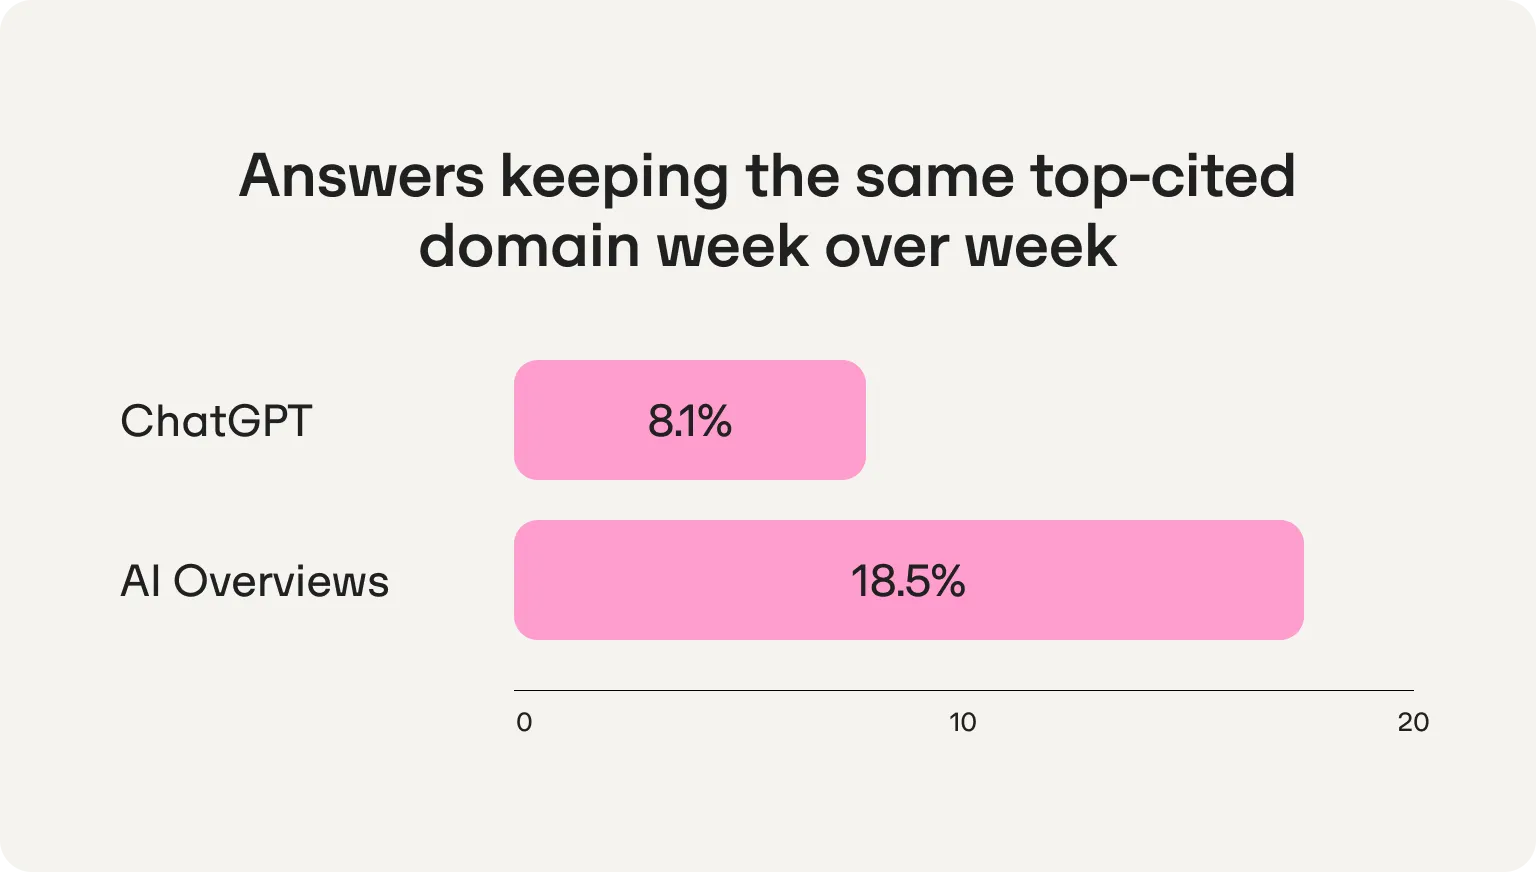
El comportamiento de ChatGPT con las citas es volátil. Según la base de datos de citas de Omnia, solo el 8,1 % de las respuestas de ChatGPT mantienen el mismo dominio más citado de una semana a otra, frente al 18,5 % de los AI Overviews. El modelo reevalúa sus fuentes constantemente. En este entorno, el contenido desactualizado o impreciso es un lastre: una página de precios con una estructura de planes antigua, una lista de funciones sin una integración reciente o una página comparativa que ya no refleja el panorama competitivo.
Esta es la conclusión que más se resisten a aceptar los equipos de SEO de marca. En las categorías de prompts comerciales («mejor software de X», «alternativas a X», «X vs. Y»), las fuentes de terceros superan sistemáticamente a los blogs de los proveedores en las citas de ChatGPT.
Según los datos de citas de Omnia y el análisis de Growth Memo de Kevin Indig sobre prompts comerciales, los sitios de reseñas, los directorios y las publicaciones editoriales acumulan la mayoría de las citas en los prompts de tipo «mejor» y «alternativas». Los blogs de los proveedores suponen una cuota bastante menor. El mecanismo es la confianza en la fuente: los modelos perciben las fuentes de terceros como más neutrales y con más autoridad en las consultas comerciales comparativas que la propia marca que se está evaluando.
La confianza de cita —la probabilidad de que un dominio concreto genere citas de forma fiable para un tipo de prompt— es sistemáticamente más alta en plataformas de reseñas y directorios comparativos que en los dominios propios de las marcas en contextos comerciales. La elegibilidad técnica es necesaria. No es suficiente. La huella de confianza fuera de tu web determina si una página elegible acaba recibiendo citas.
Este es el argumento estructural para invertir en conseguir citas externas antes de publicar otra comparativa de producto en tu propio dominio.
La mayoría de los equipos miden su visibilidad en ChatGPT como midieron el SEO al principio: revisando a mano unas cuantas consultas y formándose una impresión. Eso no es un sistema de medición. Es buscar patrones en el ruido.
Un sistema de medición repetible sustituye la «visibilidad» como concepto vago por cinco métricas operativas, una biblioteca de prompts estructurada, un protocolo de pruebas por país y una capa de responsabilidades que asigna a alguien cada señal observada.
La medición empieza por la arquitectura de prompts. Una prueba puntual de un prompt te dice lo que ChatGPT dijo una vez. Una biblioteca de prompts agrupados te dice cómo evoluciona tu visibilidad en los tipos de consulta que impulsan las decisiones comerciales.
Grupos de prompts imprescindibles:
| Grupo | Prompt de ejemplo | URL objetivo | Responsable | Prioridad |
|---|---|---|---|---|
| Categoría | «Mejores herramientas de visibilidad en IA para startups» | /homepage o /product | Responsable de SEO | Alta |
| Ideal para | «Mejor herramienta de visibilidad en IA para un equipo de marketing reducido» | página /use-case | Responsable de SEO | Alta |
| Alternativas | «Alternativas a [competidor]» | página /alternatives | Contenido | Alta |
| Comparativa | «[Marca A] vs. [Marca B]» | página /comparison | Contenido | Alta |
| Precios | «¿Cuánto cuesta [marca]?» | /pricing | Responsable de SEO | Media |
| Integraciones | «Integración de [marca] con HubSpot» | /integrations | Técnico | Media |
| Implementación | «Cómo configurar [marca]» | /docs o /guide | Técnico | Baja |
| Informativo | «¿Qué es la optimización para motores de respuestas?» | entrada de /blog | Contenido | Media |
Crea esta biblioteca en un documento compartido. Asigna responsables. Ejecuta todos los grupos con la misma cadencia. Las pruebas puntuales generan ruido; el mapeo de cobertura de prompts en una biblioteca coherente genera señal.
Cinco métricas. Definidas de forma operativa. Sin margen para interpretaciones:
La variabilidad de las respuestas es real. El mismo prompt puede producir resultados distintos según la sesión, el usuario y el estado de la recuperación. Una sola ejecución no es un dato: es una observación de un sistema probabilístico.
El impacto de la variabilidad de los prompts en cada ejecución individual es lo bastante alto como para que medir la posición con una sola ejecución lleve a conclusiones engañosas. Ejecuta cada prompt un mínimo de tres veces por sesión. Registra la respuesta completa cada vez: haz una captura de pantalla o exporta el texto, no te limites a anotar mentalmente si apareciste. Etiqueta cada segmento de la respuesta: qué marcas aparecieron, en qué posición y con qué citas.
La frecuencia de primera mención en varias ejecuciones es tu métrica de posición. Si tu marca aparece en primer lugar en dos de tres ejecuciones, tu frecuencia de primera mención para ese prompt es del 67 %. Haz seguimiento de esa cifra cada semana. Los cambios en esa cifra, y no los resultados de ejecuciones sueltas, son la señal.
Captura siempre las respuestas completas. Guárdalas siempre. Una captura de pantalla hecha una vez y sin registrar no te dice nada sobre la tendencia.
Selecciona tus 20-30 prompts comerciales principales. Ejecuta cada uno con el contexto de ubicación configurado en tus mercados prioritarios. En cada mercado, anota:
Compara los patrones de dominios citados entre mercados. En los datos de citas de Omnia, el mismo prompt «mejor herramienta de visibilidad en IA» generó preselecciones diferentes en las ejecuciones de EE. UU. y del Reino Unido: las respuestas del Reino Unido citaban blogs del sector con más frecuencia y las de EE. UU. citaban plataformas de reseñas. Si no haces pruebas por país, estás optimizando con datos incompletos.
Documenta las variaciones geográficas. Te dicen qué fuentes de citas importan en cada mercado y dónde concentrar tu trabajo de autoridad fuera de tu web.
Cada semana: los grupos de prompts comerciales principales (categoría, ideal para, alternativas y comparativa). Son los prompts que impulsan la consideración y deben monitorizarse en el ciclo más corto.
Cada mes: prompts de expansión, prompts sobre nuevas integraciones o funciones y prompts informativos ligados a contenido reciente.
Cada trimestre: auditoría completa de la entidad: ¿describe el modelo tu marca correctamente en todos los tipos de prompts? Revisión de las citas externas: ¿qué dominios han entrado en tu perfil de citas o han salido de él?
Mide medias móviles de cuatro semanas para suavizar la variabilidad que hace engañosos los datos de ejecuciones sueltas. No reacciones a una caída de la tasa de menciones en una sola sesión: probablemente sea ruido. Una tendencia a la baja durante cuatro semanas sí es una señal.
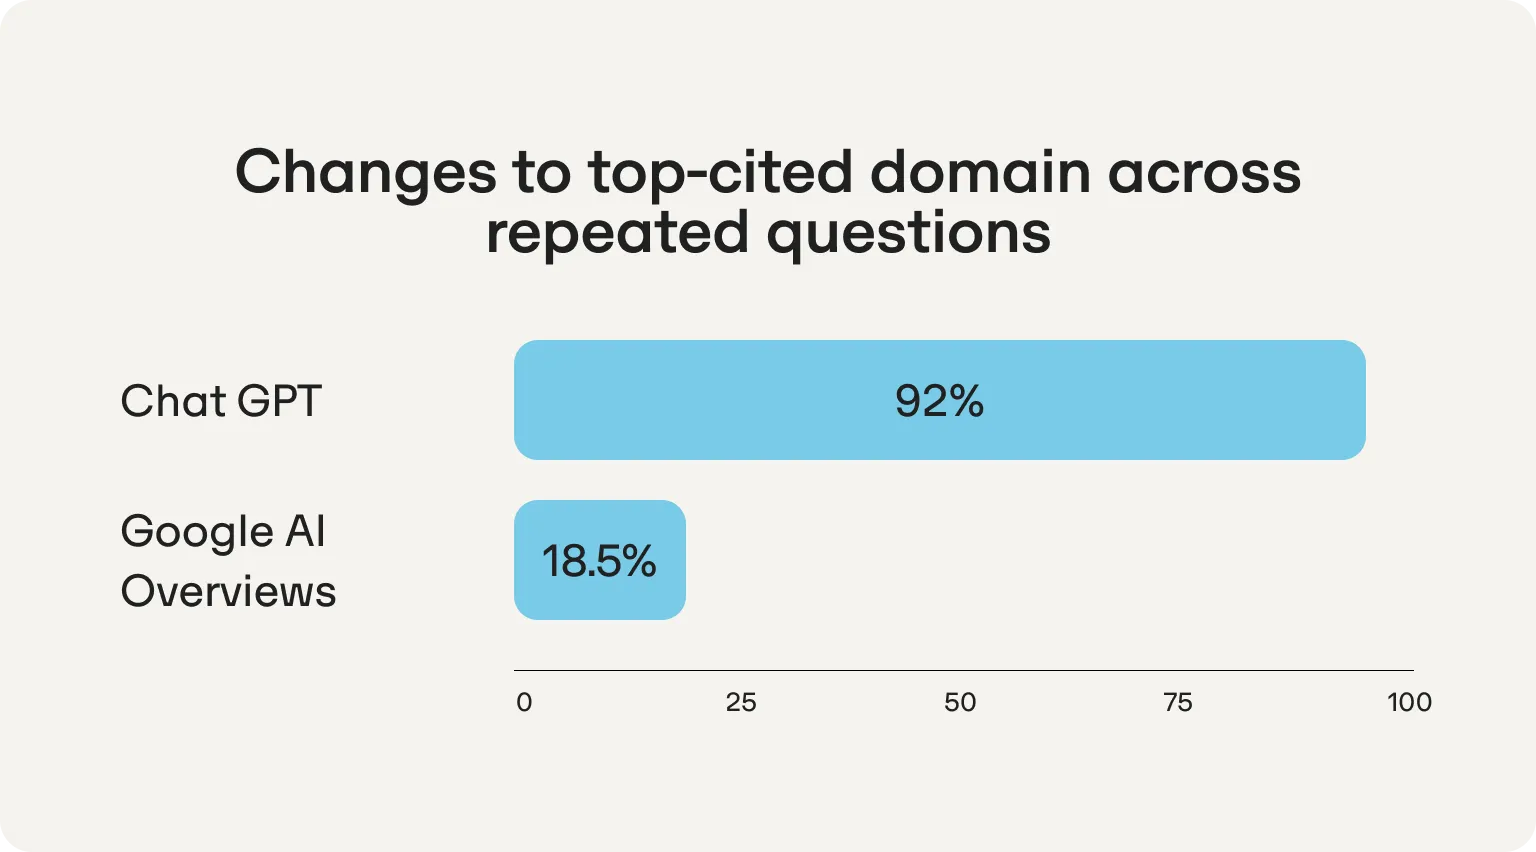
La volatilidad de la visibilidad en ChatGPT es bastante mayor que en otros motores. Según los datos de citas de Omnia, ChatGPT cambia su dominio más citado el 92 % de las veces de una semana a otra. Una cadencia de medición que trate ChatGPT como si fuera Google (informes mensuales, revisiones trimestrales) se perderá la mayor parte de la señal.
Responsables y flujo de ejecución
La medición sin responsables lleva al estancamiento. Asigna un responsable por grupo de prompts. Cada señal observada debe desencadenar una hipótesis documentada, una acción concreta, una fecha para volver a probar y un resultado registrado.
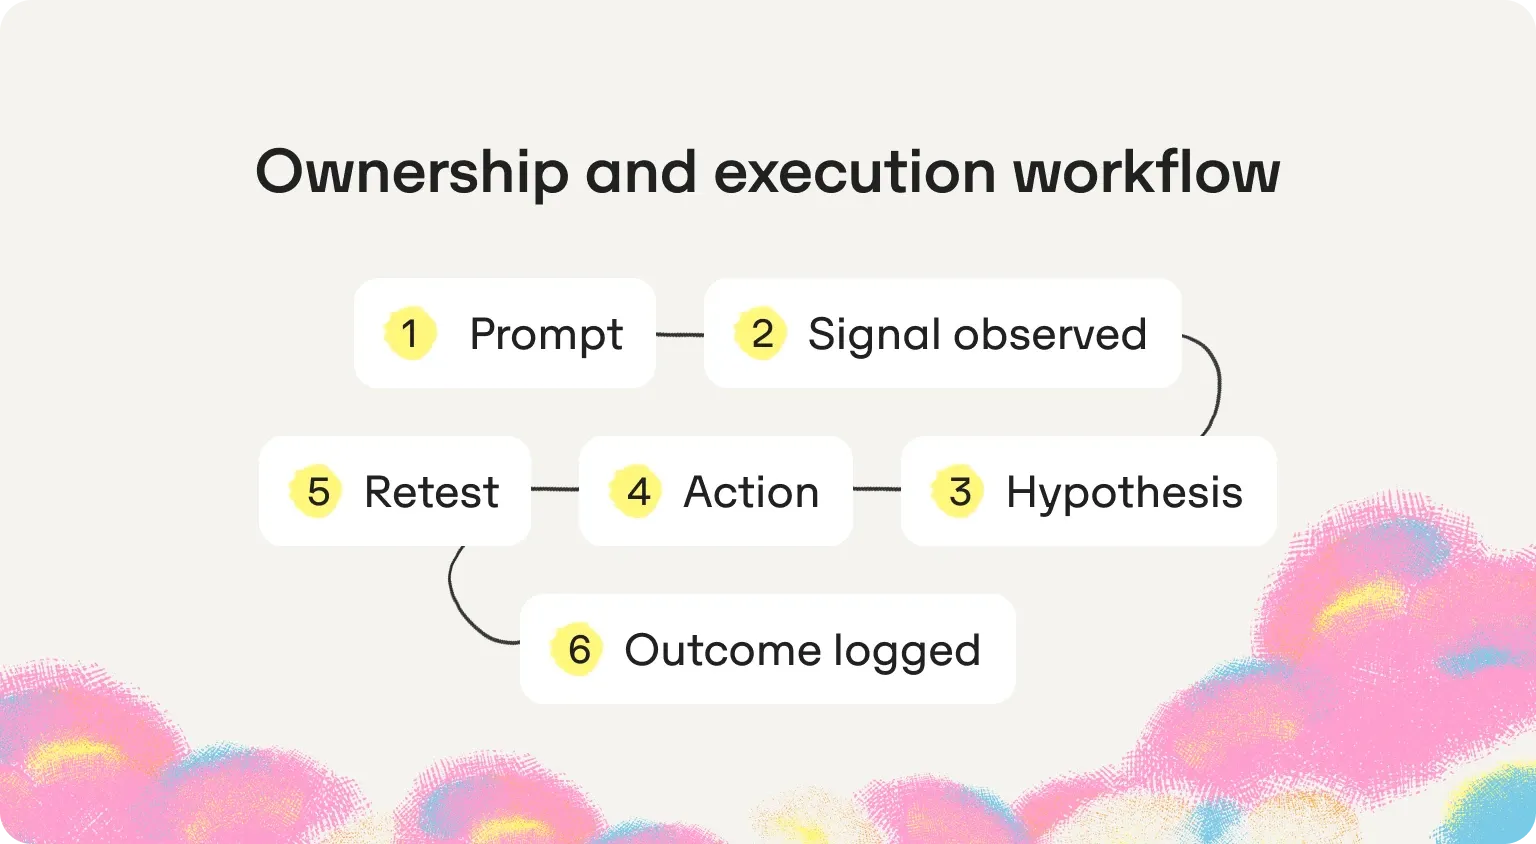
Un registro de acciones con fechas límite y seguimiento del estado no es burocracia: es la diferencia entre un sistema de medición y un simple ejercicio de elaborar informes.
La guía práctica anterior no es teórica. Los patrones que verás a continuación proceden de la base de datos de citas de Omnia, que registra más de 42 millones de citas en ChatGPT, Perplexity, los AI Overviews de Google y el Modo IA de Google.
En los grupos de prompts comerciales («mejor software de X», «alternativas a X», «cómo hacer X»), el desglose de dominios citados revela un patrón constante que la mayoría de los equipos de SEO de marca aún no han interiorizado.
En pruebas hechas en EE. UU. y el Reino Unido, los sitios de reseñas, los directorios y las publicaciones editoriales acumulan la gran mayoría de las citas de ChatGPT en los prompts de tipo «mejor» y «alternativas». Los blogs de los proveedores suponen una cuota bastante menor. El patrón se mantiene en todos los mercados, aunque los dominios concretos cambian: los prompts comerciales de EE. UU. se apoyan en plataformas de reseñas y los del Reino Unido, más en sitios editoriales del sector.
La conclusión es directa: en los prompts comerciales, la huella de confianza fuera de tu web importa más que publicar otra comparativa en tu propio dominio. La matriz de optimización multimotor es distinta para cada motor: el perfil de citas comerciales de ChatGPT está más dominado por medios editoriales que el de Perplexity o el del Modo IA.
Uno de los patrones más constantes en los datos de visibilidad en ChatGPT es la brecha entre la tasa de menciones y la tasa de citas. Una marca puede aparecer por su nombre en el 60 % de los prompts probados y, sin embargo, ver citada su URL solo en el 15 % de esos mismos prompts.
Esta brecha es significativa. Indica que el reconocimiento de la marca como entidad se está formando —el modelo sabe quién eres—, pero que tu autoridad como fuente aún no ha alcanzado el umbral necesario para una cita directa con URL. Según los datos de Omnia, ChatGPT ofrece de media solo cuatro huecos para citas por respuesta, y esa cifra ha caído aproximadamente un 30 % desde mediados de 2025. El modelo es cada vez más selectivo. Si tu tasa de menciones sube y tu tasa de citas se estanca o baja, tu entidad es visible, pero tu contenido no inspira suficiente confianza como fuente para ocupar uno de los cuatro huecos disponibles.
Lo que cierra la brecha: un schema que refuerce la claridad de la entidad, una estructura de página que mejore la facilidad de extracción y citas de terceros que construyan autoridad como fuente fuera de tu propio dominio.
Los mismos prompts producen resultados sustancialmente distintos según el mercado. En las pruebas de Omnia, ejecutar cinco prompts idénticos del tipo «mejor herramienta de visibilidad en IA» en EE. UU., el Reino Unido y un mercado europeo secundario generó tres preselecciones de proveedores diferentes, sin coincidencia en el dominio más citado entre las ejecuciones de EE. UU. y del Reino Unido.
La diferencia en el patrón de citas no se limitaba a la visibilidad de las marcas. En las ejecuciones del Reino Unido dominaban las citas de publicaciones editoriales del sector. En las de EE. UU., las de plataformas de reseñas. Una misma marca con una presencia sólida en G2, pero sin cobertura editorial en el Reino Unido, parecería fuerte en las respuestas de ChatGPT en EE. UU. e invisible en las del Reino Unido.
Si operas en varios mercados y solo haces pruebas en uno, estás tomando decisiones de optimización con la mitad de los datos.
Para los equipos que necesitan una única métrica derivada para seguir su progreso e informar a la dirección, esta puntuación compuesta es un punto de partida. No es un resultado del modelo: es un agregado que se calcula a mano y da una sola cifra para seguir la tendencia de forma orientativa.
Visibility Score = (0,4 × tasa de menciones) + (0,3 × tasa de citas) + (0,2 × frecuencia de primera mención) + (0,1 × exactitud del relato)
Las ponderaciones reflejan la importancia relativa de cada métrica para la visibilidad comercial en ChatGPT: la tasa de menciones es la señal más amplia; la tasa de citas, la más directamente atribuible al contenido y a la autoridad fuera de tu web; la frecuencia de primera mención refleja el posicionamiento competitivo, y la exactitud del relato es una señal cualitativa que lleva la ponderación más baja por su naturaleza manual.
Usa esta puntuación para hacer seguimiento de medias móviles de cuatro semanas. Una tendencia al alza sostenida de ocho a 12 semanas es una señal significativa. Un pico de una sola semana, no.
El concepto de AI Visibility Score es la versión formalizada de esto: la métrica compuesta que Omnia mide automáticamente, sin necesidad de calcularla a mano en cada conjunto de prompts.
El sistema de medición anterior se puede ejecutar a mano con un conjunto de prompts pequeño en un solo mercado. Con 30 prompts en tres países y una cadencia semanal, se convierte en un trabajo a tiempo completo. Esa es la brecha que cierra Omnia.
Para el estratega de SEO de una startup financiada con capital riesgo o del equipo reducido de una scaleup, que necesita ciclos de feedback rápidos y no tolera los plazos de seis meses de una agencia, Omnia ofrece la infraestructura para hacer funcionar este sistema sin ampliar la plantilla gracias a:
La mayoría de las herramientas de monitorización de búsquedas con IA te muestran lo que ha pasado. Omnia te muestra qué hacer al respecto y te da el flujo de trabajo para hacerlo en una sesión a la semana.
Omnia ofrece una prueba gratuita de 14 días con el plan Growth.
Sin tarjeta de crédito. Descubre exactamente dónde aparece tu marca (y dónde no) en los motores de IA y deja que las recomendaciones de la plataforma te marquen el siguiente paso.

Gana presencia en las fuentes en las que ChatGPT ya confía para tu categoría: plataformas de reseñas, directorios del sector y publicaciones editoriales que aparecen en las citas de ChatGPT para prompts parecidos a los tuyos. Las menciones de marca en ChatGPT dependen en parte del reconocimiento de entidad que se construye en fuentes externas, no solo en tu propio dominio. Describir tu marca de forma coherente en G2, en tu web y en cualquier cobertura de prensa acelera ese reconocimiento. El seguimiento de citas de Omnia identifica qué dominios concretos están dando forma a las respuestas de tu categoría para que sepas exactamente dónde ganar presencia.
El camino más rápido está fuera de tu web: un perfil completo en la plataforma de reseñas que ChatGPT cita de forma sistemática en los prompts de tu categoría, junto con al menos una o dos menciones editoriales en publicaciones que formen parte de la huella de citas de tu categoría. Estas acciones mueven la tasa de menciones de forma medible en un plazo de dos a cuatro semanas. Publicar contenido nuevo en tu propio dominio sin trabajar antes la capa de citas externas es más lento y menos fiable para conseguir menciones directas en ChatGPT.
Para que te citen, primero tienes que cumplir los criterios de elegibilidad: tus páginas deben estar indexadas en Bing, mostrar el contenido principal en HTML renderizado en el servidor y tener etiquetas canónicas limpias. Una vez que eres elegible, la probabilidad de que te citen aumenta con la facilidad de extracción del contenido (una jerarquía H1–H3 clara, bloques de definición y respuestas directas a preguntas concretas en las primeras 300 palabras) y con la autoridad de fuentes externas que consigues gracias a citas de terceros en dominios de confianza. Consulta los siete fundamentos técnicos de más arriba para ver la lista de comprobación completa de elegibilidad y facilidad de extracción.
Reddit forma parte del conjunto de fuentes que cita ChatGPT, pero con menos frecuencia que Wikipedia, las publicaciones editoriales y las plataformas de reseñas en la mayoría de los tipos de prompts comerciales. Reddit es más útil como señal de entidad (las menciones coherentes de tu marca en debates de subreddits relevantes refuerzan su reconocimiento) que como fuente principal de citas. En los prompts comerciales del tipo «mejor X» y «alternativas», las plataformas de reseñas y los directorios editoriales superan sistemáticamente a Reddit en frecuencia de citas en ChatGPT. Trabaja tu presencia en Reddit para que descubran tu marca, y en las plataformas de reseñas para que te citen.
No existe una posición n.º 1 fija y universal en ChatGPT. Las respuestas varían según el usuario, el país, el modo de recuperación y la formulación del prompt. Lo que sí puedes optimizar es la frecuencia de primera mención: cuántas veces aparece tu marca como el primer proveedor que se nombra en varias ejecuciones del mismo prompt. Mídela como media móvil en toda tu biblioteca de prompts, no como una observación de una sola sesión. Una frecuencia de primera mención constante por encima del 50 % en tus prompts comerciales principales es una señal significativa de un posicionamiento sólido en la categoría.
La búsqueda de ChatGPT (respuestas generadas por recuperación con datos en tiempo real del índice de Bing) y las respuestas de ChatGPT (basadas sobre todo en los datos de entrenamiento) requieren estrategias que se solapan, pero son distintas. En ChatGPT con la búsqueda activada, la indexación en Bing es la puerta de acceso: las páginas que no están en el índice de Bing no pueden recibir citas, por bueno que sea su contenido. En ambos modos importan la coherencia de la entidad, la facilidad de extracción del contenido y la autoridad fuera de tu web. La distinción de la herramienta de seguimiento de posiciones en ChatGPT es relevante para la medición: las citas en modo búsqueda se miden de forma más fiable porque incluyen la URL; las apariciones en modo respuesta pueden mostrar nombres de marca sin una URL citable.
Apunta a prompts long tail de alta intención en tu categoría en lugar de a consultas genéricas del tipo «mejor software de X», donde los actores consolidados ya ocupan los huecos para citas. Las startups con poca autoridad consiguen entrar de forma sistemática en las citas de ChatGPT construyendo presencia en las dos o tres fuentes externas que dominan las citas de su nicho concreto (a menudo, una plataforma de reseñas especializada en la categoría y una o dos publicaciones del sector) en lugar de competir a escala global en decenas de prompts. El comprobador de posicionamiento en IA te da rápidamente un punto de partida sobre dónde está tu marca ahora mismo antes de decidir a qué prompts apuntar.
Cinco métricas con una cadencia semanal: tasa de menciones, tasa de citas, share of voice, frecuencia de primera mención y exactitud del relato. Ejecuta cada semana tu biblioteca de prompts comerciales principales en tus mercados prioritarios. Sigue medias móviles de cuatro semanas, no resultados de sesiones sueltas. Añade una comparación por país a cada prueba de prompts principales. Si la tasa de menciones de un prompt cae más de 10 puntos porcentuales de una semana a otra, márcalo para investigarlo antes de actuar. El seguimiento de la visibilidad en IA y el seguimiento del Modo IA de Omnia ejecutan este sistema automáticamente, así que la capa de medición trabaja en segundo plano mientras tu equipo se centra en las acciones que mueven los números.
Escrito por
 AndreiHead of GrowthenOmniaJoseGrowthenOmnia
 Miguel FernándezCTO y fundadorenOmnia
 JoseGrowthenOmnia
 El equipo de Omnia
 El equipo de Omnia
Sin tarjeta de crédito · Gratis durante 14 días · Descubre tu visibilidad en IA en 3 minutos