LLM
Cómo hacer una auditoría GEO paso a paso en 2026

 AndreiHead of GrowthenOmnia
 JoseGrowthenOmnia
Este informe documenta seis patrones de sesgo detectados en ChatGPT a partir de 20 días de datos empíricos de visibilidad: 8 marcas SaaS B2B, 8 categorías de producto y 4 grandes motores de IA (ChatGPT, Perplexity, AI Overviews de Google y Modo IA de Google). El objetivo es identificar en qué puntos las recomendaciones de ChatGPT se alejan de la realidad del mercado y entender los mecanismos que explican esas diferencias.
Los datos muestran un sistema que responde menos a la situación actual del mercado que a la estructura de su corpus de entrenamiento: una dependencia desproporcionada de Wikipedia, un conjunto de fuentes citadas concentrado en unos pocos dominios de gran autoridad, una sobrerrepresentación constante de los productos de Microsoft y del entorno de OpenAI, y una dependencia casi total del contenido de reseñas de terceros frente a los recursos propios de las marcas.
Los seis patrones se repiten de forma sistemática en todas las categorías, marcas y periodos.
ChatGPT se promociona sistemáticamente cuando le preguntan por asistentes de IA, pero no aparece entre las fuentes dominantes de ninguna otra categoría. La autopromoción es selectiva, no universal.
Pruebas:
Implicaciones para la marca: Claude parte con una desventaja estructural, porque el motor que lo evalúa es su principal competidor. En cualquier análisis competitivo de la categoría de asistentes de IA, los datos de ChatGPT deben interpretarse teniendo en cuenta esta distorsión.
En la categoría de herramientas para desarrolladores, ChatGPT cita y recomienda el ecosistema Microsoft/GitHub 2,1 veces más que Cursor, líder de la categoría según su propio SOV.
Pruebas:
Mecanismo: Microsoft invirtió 10.000 millones de dólares en OpenAI y, por contrato, todo el acceso sin estado (stateless) a la API de OpenAI pasa por Azure. Esta relación genera una asimetría de presencia en los datos de entrenamiento y, posiblemente, en los criterios de relevancia del modelo.
Implicaciones para la marca: el SOV de Cursor en ChatGPT infravalora su posición real en el mercado. Para las marcas de categorías en las que compiten socios inversores de OpenAI, el Modo IA de Google y Perplexity son referencias más neutrales.
En 5 de las 8 categorías analizadas, ChatGPT se comporta de forma equitativa: las marcas aparecen en proporción a lo que parece ser su autoridad real en el mercado, sin sobrerrepresentación de los socios comerciales ni de los inversores de OpenAI.
Pruebas:
Implicaciones para la marca: para las marcas de categorías neutrales, el SOV en ChatGPT es un indicador fiable de su posicionamiento real.
ChatGPT usa Wikipedia como fuente principal de forma desproporcionada. Las marcas con artículos de Wikipedia más extensos y actualizados reciben más citas en ChatGPT, al margen de su relevancia actual en el mercado.
Pruebas:
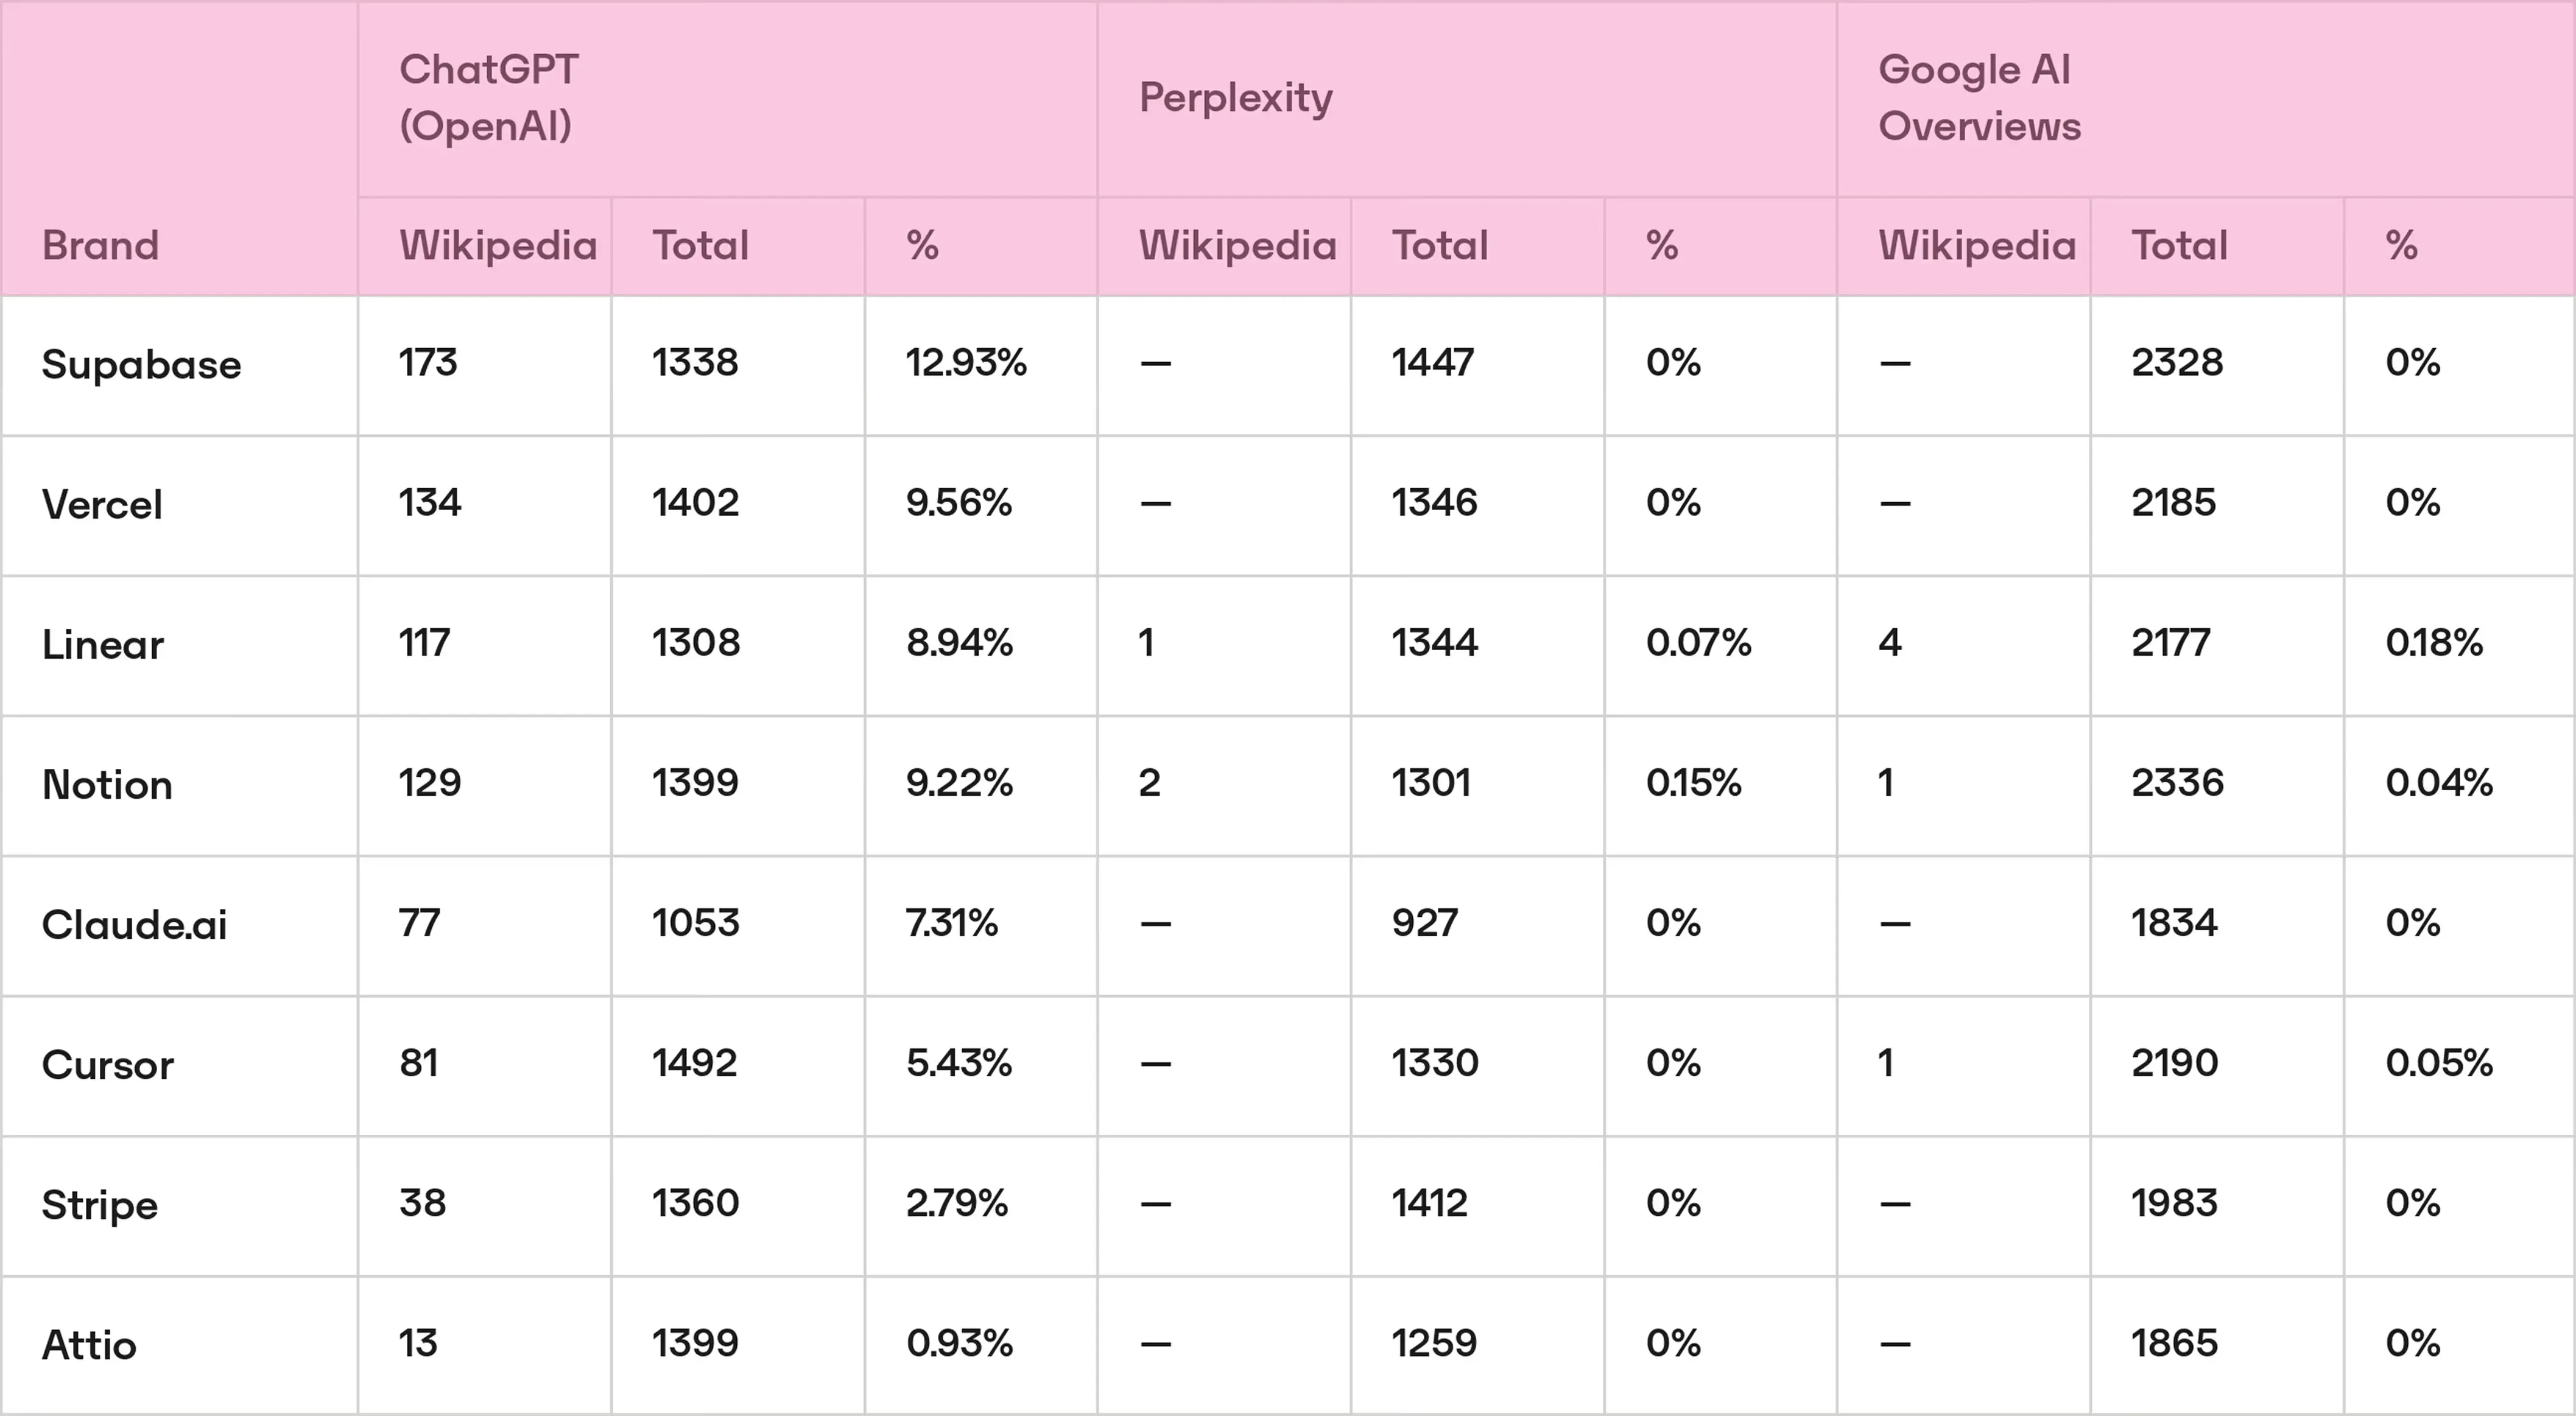
Mecanismo: la causa de fondo es arquitectónica. ChatGPT se entrenó con volcados de Wikipedia como fuente de conocimiento estructurada y de alta calidad, y ese peso asignado durante el entrenamiento se mantiene en su forma de citar en el momento de la inferencia. Wikipedia funciona como un indicador indirecto de autoridad, tanto si un artículo refleja con precisión el panorama competitivo actual como si no.
Implicaciones para la marca: según los datos de este estudio, tener presencia en Wikipedia es hoy la palanca con mayor ROI para mejorar la visibilidad en ChatGPT. Para las marcas jóvenes y las startups, la calidad del producto por sí sola no cierra a corto plazo la brecha de autoridad histórica: el conocimiento previo del modelo ya está fijado, y el contenido reciente de terceros no lo modificará al mismo ritmo que lo haría un artículo de Wikipedia bien mantenido.
OpenAI trabaja con un conjunto de fuentes bastante más reducido que el de otros motores, pero cita cada una de ellas más veces. Esto crea una barrera de entrada alta: lo que determina la visibilidad es estar entre los dominios de referencia, no la amplitud de la presencia en la web.
Pruebas:
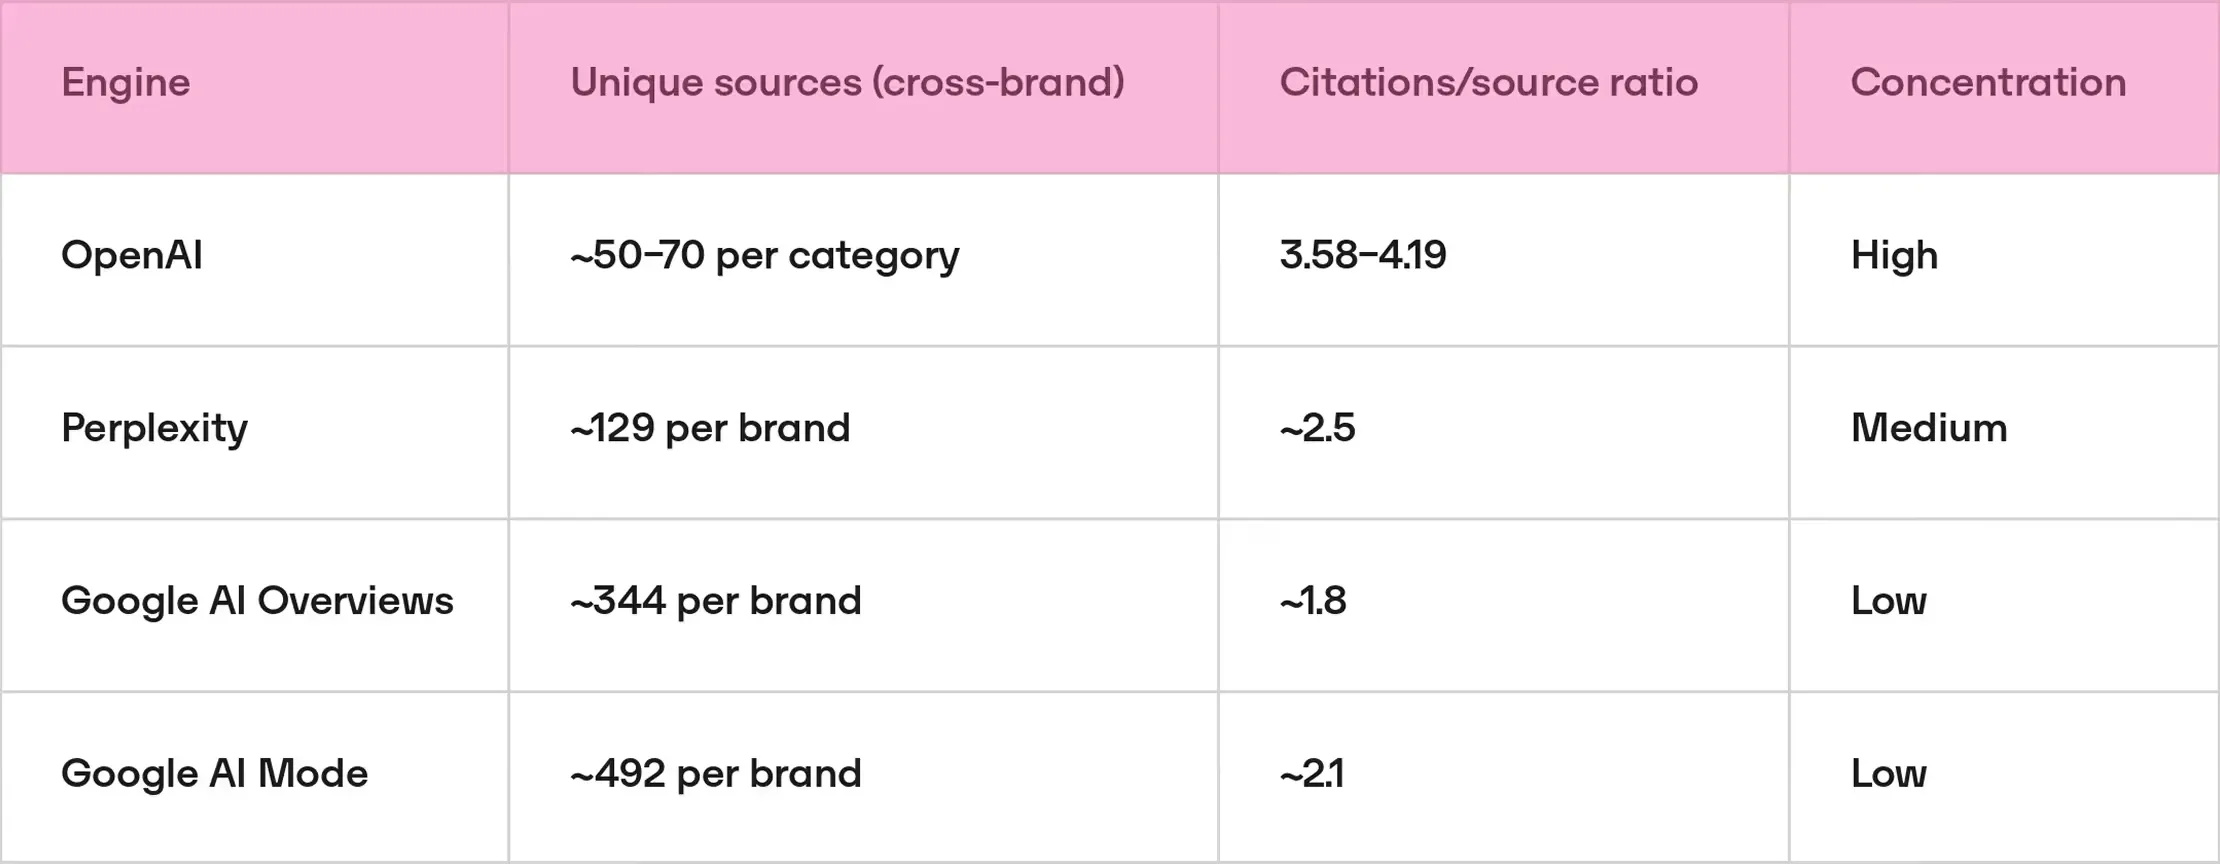
Mecanismo: ChatGPT no hace RAG (recuperación en tiempo real) del mismo modo que Perplexity o el Modo IA de Google. Sus respuestas se generan en gran medida a partir de patrones aprendidos durante el entrenamiento, lo que concentra las referencias en un conjunto de fuentes que el modelo «recuerda» con más frecuencia.
Implicaciones para la marca: para aparecer en ChatGPT es más eficaz ganar presencia en 5-10 dominios de gran autoridad que conseguir menciones dispersas en cientos de sitios. La estrategia de contenido debe priorizar la calidad de las fuentes frente al volumen de menciones.
En las 8 marcas, el desglose por tipo de fuente en ChatGPT tiene una estructura casi idéntica: aproximadamente un 89 % de terceros, un 9 % de fuentes sociales (Wikipedia, Reddit, LinkedIn) y menos de un 2 % de contenido propio. Esta proporción se mantiene sea cual sea la categoría, el tamaño de la marca o su posición en SOV.
Dentro del contenido de terceros, un mismo arquetipo domina en todas las categorías: los artículos comparativos y las reseñas de «pros y contras». Las URL más citadas de cada marca siguen casi exclusivamente esta plantilla:
Pruebas:
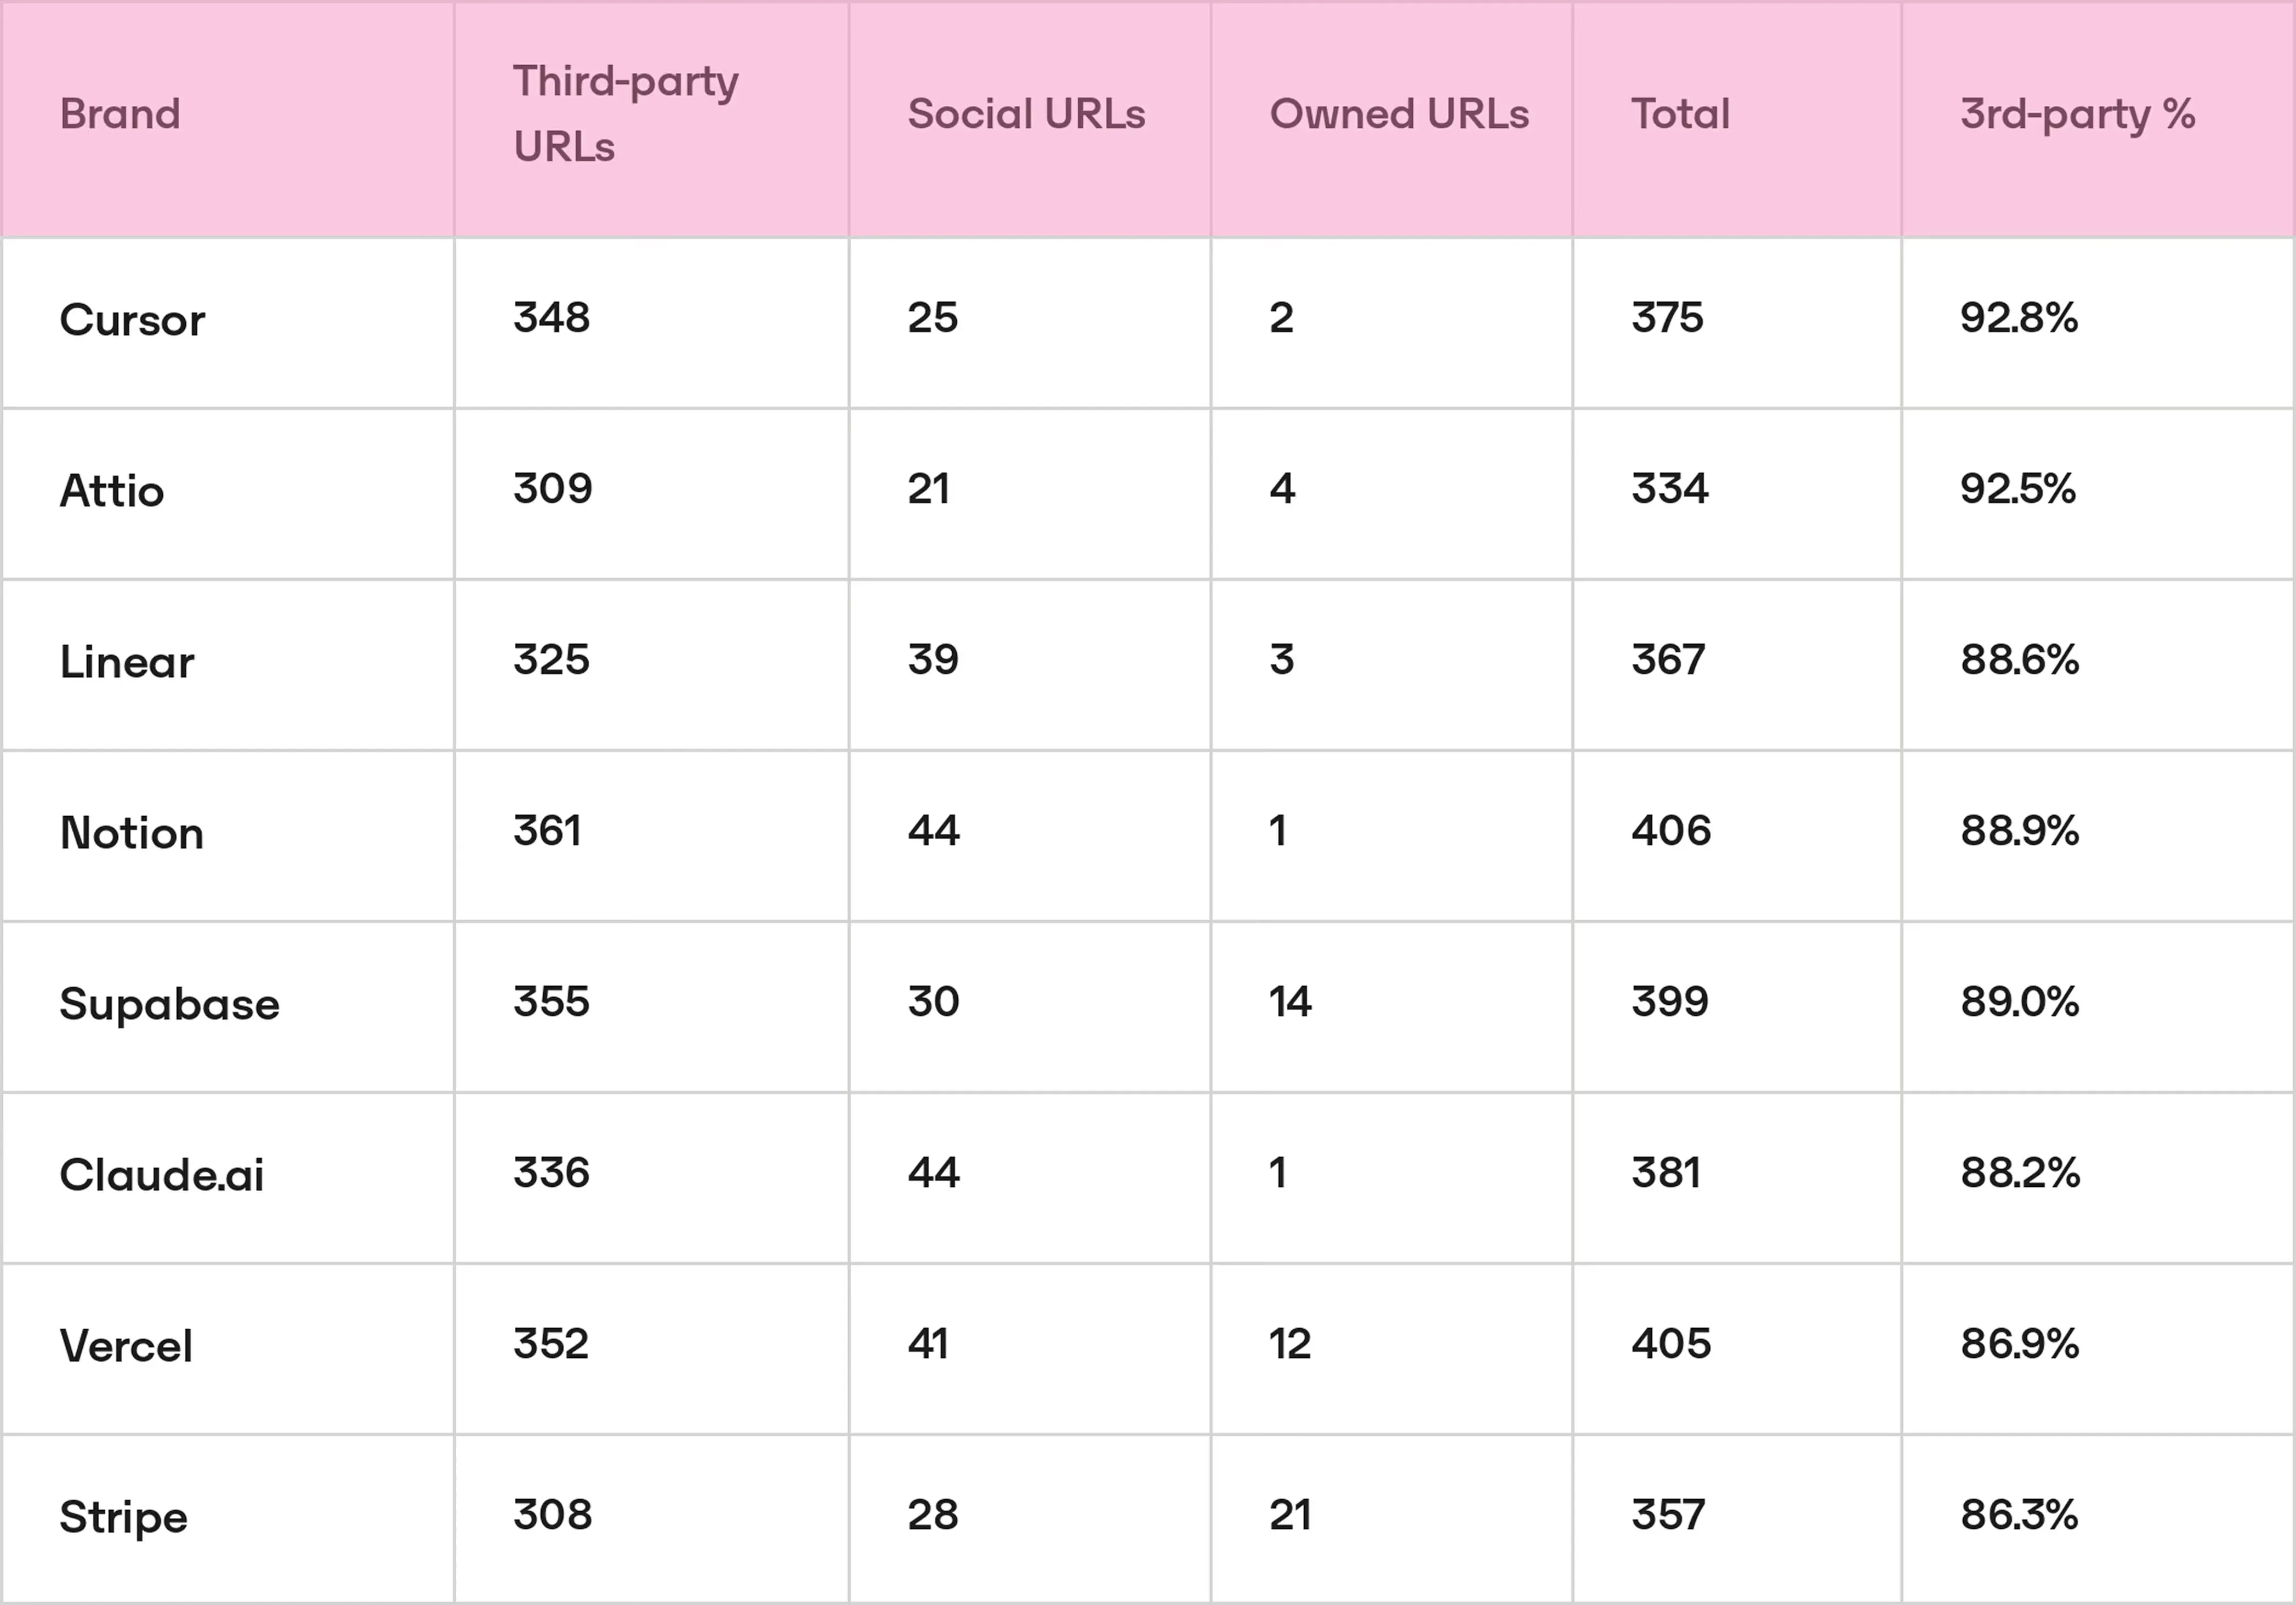
Fíjate en que, en varios casos, los artículos de terceros más citados tratan principalmente sobre un competidor, y la marca estudiada aparece como referencia secundaria. La cita principal de Stripe es una reseña de Paddle. La cita principal de Vercel es una reseña de Fly.io. Esto significa que las marcas pueden acumular una exposición negativa en las citas: aparecen como la opción inferior en la reseña de un competidor sin tener ningún control sobre cómo se las presenta.
Mecanismo: ChatGPT no hace recuperación en tiempo real. Su forma de citar refleja lo que se indexó y ponderó durante el entrenamiento. El contenido de reseñas y comparativas está muy enlazado desde comunidades de desarrolladores, agregadores y recopilatorios de newsletters, lo que le da un peso desproporcionado en un corpus entrenado con señales de autoridad basadas en el grafo de enlaces. Que la proporción del 89 % se repita en las 8 marcas apunta a que se trata de un rasgo estructural de cómo cita ChatGPT, no de un artefacto propio de una categoría.
Implicaciones para la marca: para ganar visibilidad en ChatGPT, la inversión estratégica en contenido consiste en conseguir presencia en artículos comparativos y reseñas de terceros, no en publicar contenido de marca. En concreto, conviene apuntar a los artículos del tipo «Mejores herramientas de [categoría]» y «[Marca] vs. [Competidor]» en publicaciones tecnológicas consolidadas. No aparecer en esos artículos, o aparecer solo como opción secundaria, limita directamente tu cuota de citas en ChatGPT. Los datos también sugieren que monitorizar las reseñas sobre tus competidores es tan importante como monitorizar las de tu marca: si una reseña sobre un competidor presenta una y otra vez tu marca como la opción más débil, es probable que ese encuadre se esté trasladando a las respuestas de ChatGPT.
Los seis patrones de sesgo que documenta este informe tienen una raíz común: lo que responde ChatGPT refleja sus datos de entrenamiento, no solo una lectura en directo del mercado.
Algunos de estos sesgos son arquitectónicos, como la dependencia de Wikipedia o la concentración de las citas en un conjunto fijo de fuentes. Otros son relacionales y nacen de los vínculos comerciales de OpenAI con Microsoft y GitHub. Y otros son rasgos estructurales de cómo se ponderó el contenido web durante el entrenamiento. En todos los casos, el resultado es el mismo: las clasificaciones que genera ChatGPT no son una medida 100 % neutral de la autoridad actual de las marcas.
Esto tiene una implicación metodológica directa. En las categorías en las que ChatGPT tiene un conflicto de intereses, como los asistentes de IA o las herramientas para desarrolladores próximas al ecosistema de Microsoft, Perplexity y el Modo IA de Google ofrecen comparativas menos distorsionadas. Usar ChatGPT como referencia principal de visibilidad en esas categorías supone interpretar los resultados a través de un filtro que los propios datos ponen en duda.
Omnia ofrece una prueba gratuita de 14 días con el plan Growth.
Sin tarjeta de crédito. Descubre exactamente dónde aparece tu marca (y dónde no) en los motores de IA y deja que las recomendaciones de la plataforma te marquen el siguiente paso.
Escrito por
 JoseGrowthenOmniaAndreiHead of GrowthenOmnia
 JoseGrowthenOmnia
 JoseGrowthenOmnia
 AndreiHead of GrowthenOmnia
 AndreiHead of GrowthenOmnia
Sin tarjeta de crédito · Gratis durante 14 días · Descubre tu visibilidad en IA en 3 minutos